Document Intelligence ファイル形式別 解析性能徹底検証!
Document Intelligenceとは
こんにちは!インターセクトでエンジニアをしている網野です。
今回はAzure AI Document Intelligenceのファイル形式別の性能を検証した結果を皆様に共有したいと思います。
Azure AI Document Intelligenceは、高度な機械学習を応用して、ドキュメントから正確にデータを抽出するクラウドサービスです。
文書処理を自動化し、ビジネスプロセスの変更に迅速に適応することを可能にします。
本記事をご覧になっている皆様におかれましては、Document Intelligenceについての基礎知識を有している方と思われますので、ここではこれ以上の詳細な説明は省かせていただきます。
本記事の目的と対象読者
本記事の目的は、Azure AI Document Intelligenceの各ファイル形式に対する解析性能を詳細に分析し、その実用性と限界を検証することです。この検証を通じて、Document Intelligenceの実際の能力と適用可能性についての洞察を提供したいと考えています。
AIと機械学習を活用したドキュメント処理ソリューションの開発に携わる技術者、組織のドキュメント処理の効率化やデジタル化を検討している方、データ駆動型の意思決定プロセスの改善を目指すビジネスアナリスト、革新的なドキュメント処理ソリューションの開発を検討している起業家、そしてAIと文書処理の分野に興味を持つ学生や研究者などを対象に想定しています。
Document Intelligenceの概要と最新動向
主要機能と特徴
Azure Document Intelligenceは機械学習、自然言語処理、コンピュータビジョン技術を統合し、多様な形式の文書を処理します。スキャンされたテキスト、HTML、PDF、画像など、様々な形式に対応し、文書の分析、データ抽出、変換を自動化します。特筆すべきは、AIアルゴリズムを活用して重要フィールドを予測し、異なるレイアウトや形式の調達文書にも適応できる点です。これにより、データ抽出の正確性が向上し、操作の柔軟性が高まります。
さらに、このサービスはカスタマイズ能力を持ち、ユーザーが定義した情報を基に継続的に改善します。これによりパフォーマンスが向上し、組織固有のニーズに適応していきます。
最新のアップデート(2024年8月現在)
Azure Document Intelligenceの最新の大規模アップデートは2024年2月に行われました。この更新では、APIの改善や新しいモデルの導入など、多岐にわたる機能強化が実施されました。
主な変更点として、レイアウトモデルにおける図の検出機能の追加や、階層型ドキュメント構造分析の導入が挙げられます。また、カスタム抽出モデルでは、セル、行、テーブルレベルの信頼度スコア(confidence値)のサポートが追加され、フィールド抽出のAI品質も向上しました。
さらに、新たな事前構築モデルとして、住宅ローンドキュメント、クレジット/デビットカード、結婚証明書などが追加されました。これらの新モデルにより、特定の文書タイプに対するデータ抽出の精度と効率が大幅に向上しています。
2024年8月現在、2月以降の大規模なアップデートのアナウンスはありませんが、AIと機械学習技術の急速な進歩を考慮すると、近い将来、さらなる機能強化や新しいユースケースに対応したモデルの登場が予想されます。期待して待ちましょう。
一般的なユースケース
Azure Document Intelligenceは幅広い企業部門で活用できます。
例えば一般的なユースケースとしていくつかの例をあげてみましょう。ITサービス管理でインシデントレポートや変更要求から重要情報を抽出し、対応の迅速化を支援します。フィールドサービス管理では、作業指示書や報告書の処理を自動化し、効率を向上させます。人事部門では、履歴書や従業員文書の分析を効率化し、採用プロセスや人事管理を最適化します。
また、弊社の開発しているサービス”Askhub”の高精度データ解析機能においても、ユーザーがアップロードしたドキュメントを構造化する手順の初期段階で利用しています。
ファイル形式別の詳細検証
検証の目的と方法
本検証の目的は、Azure AI Document Intelligenceの各ファイル形式に対する解析性能を徹底的に評価し、その実用性と制限を明らかにすることです。
以前、弊社サービスAskhubのバックエンド開発においてパワーポイントファイルの解析を試した際、期待通りの結果が得られなかった経験(詳細は後述)を踏まえ、サポートされている全ての拡張子に対して包括的な能力テストを行うことにしました。
検証方法として、Azure上で提供されている最新のテスト環境である「Azure AI Document Intelligence Studio」を使用します。なお、APIバージョンは2024年8月時点の最新である「2024-02-29(Preview)」を利用しています。
具体的な手順としては、まず各ファイル形式(PDF、Word、Excel、PowerPoint、画像ファイルなど)のサンプルドキュメントを用意します。これらのドキュメントには、テキスト、表、画像、図形などの様々な要素を含めることで、幅広いシナリオをカバーします。
次に、これらのサンプルドキュメントを「Azure AI Document Intelligence Studio」にアップロードし、Document Intelligenceの各機能(レイアウト分析、エンティティ抽出、テーブル認識など)を適用、各処理の結果を分析し評価を行います。
この包括的な検証を通じて、Azure AI Document Intelligenceの実際の能力と限界を明らかにし、様々なビジネスシナリオにおける適用可能性を評価します。また、この検証結果を基に、今後のDocument Intelligenceの改善点や、私たち開発者が注意すべき点についても考察を行っていきましょう。
検証結果
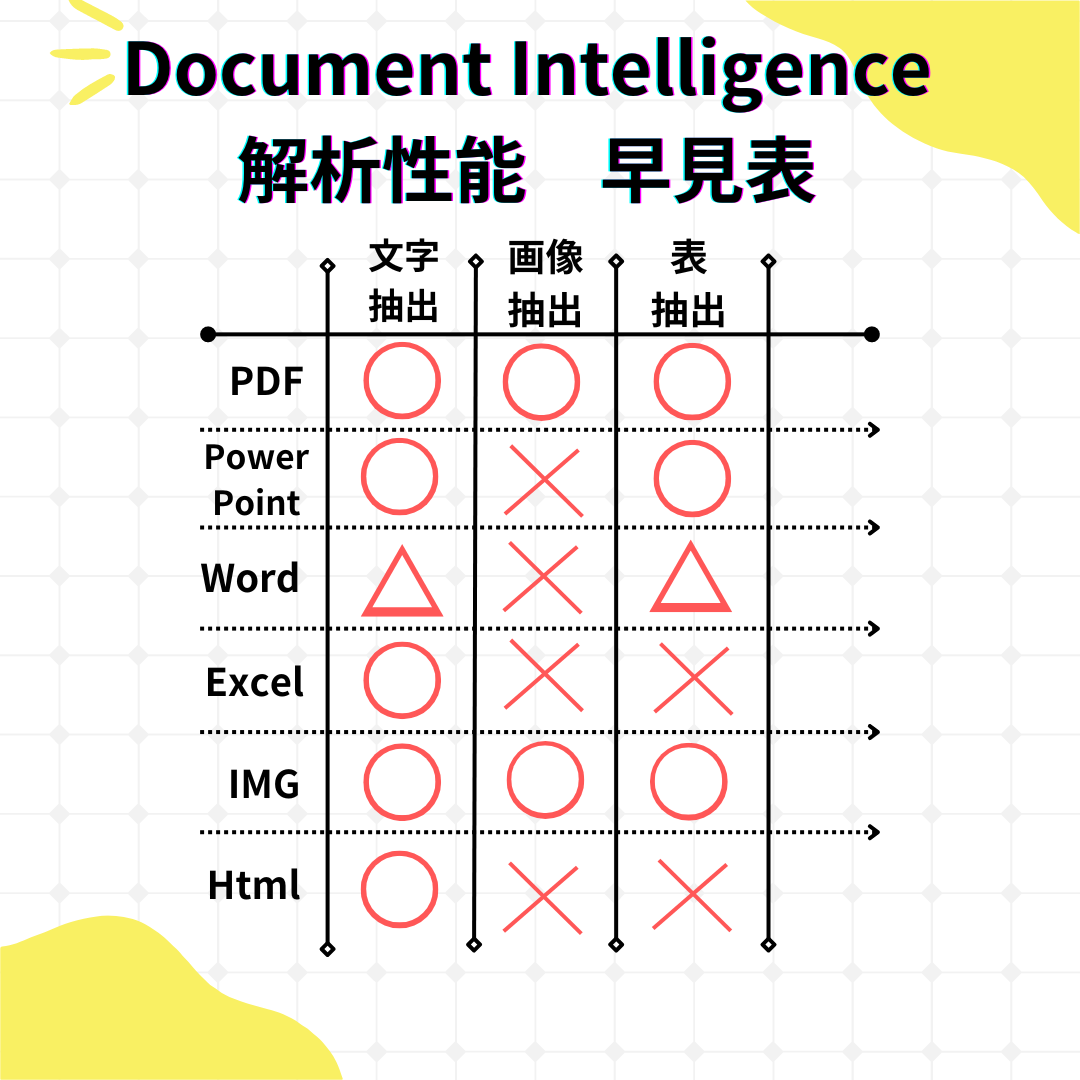
まずは長々と文章を読みたくない方々のために結果を共有いたします。 今回の検証の結果はこちらです。
PDF(.pdf) -及び基本的なレスポンスボディの解説
まず、Document Intelligenceに弊社の提供するAskhubのサービス概要資料.pdfを投げて得られたレスポンスをもとに、基本的なレスポンスのパラメータをおさらいしていきます。
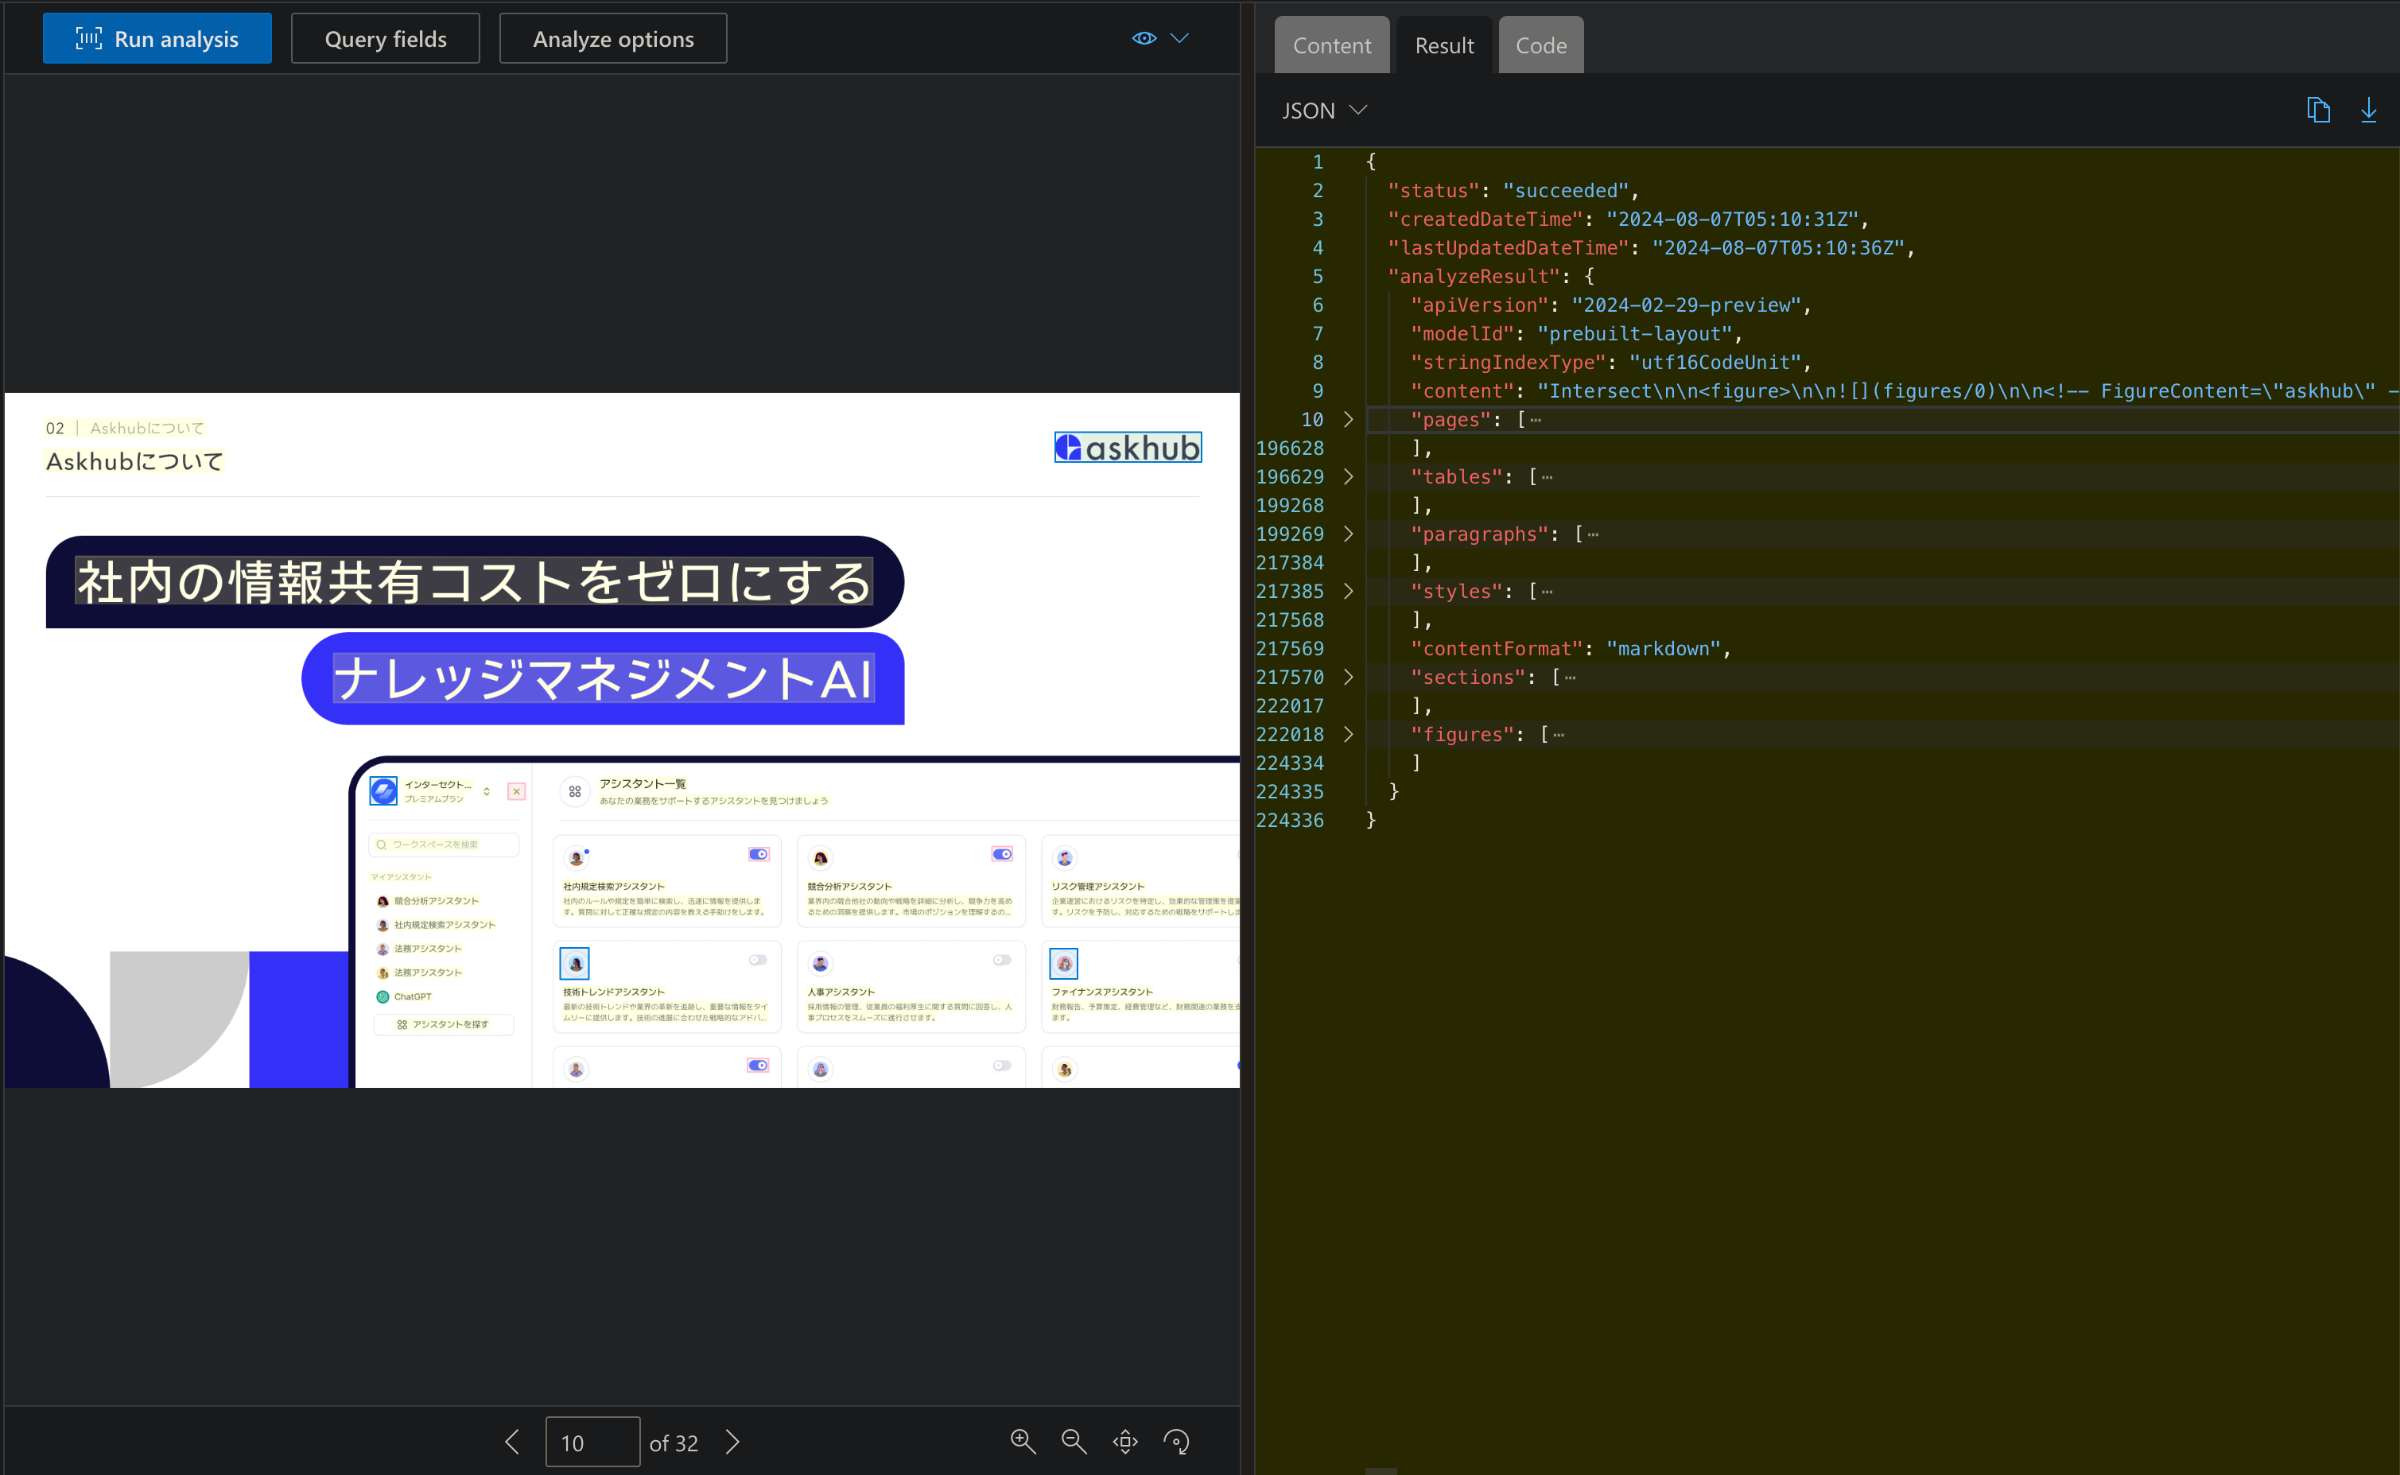
こちらが得られたレスポンスとなります。(markdownオプションを適用しています)
主なレスポンスの構成をざっくりと解説します。
pages: 各ページの情報を含む配列pageNumber: ページ番号width,height: ページの寸法。単位としてunitが付随します。angle: ページの回転角度lines: テキスト行の配列words: 単語と、その位置情報を含む配列tables: 検出された表テーブルの情報rowCount,columnCount: 行数と列数cells: 各セルの内容と行、列の位置情報および、セルの内容を配列化したものboundingRegions: 表の位置情報paragraphs: 段落としての情報。azure公式にて”論理単位を形成する行の順序付けされたシーケンス” とある。フレンチのコースの一皿みたいですね。styles: 使用されているフォントやスタイルの情報sections: 文書の論理的な区分を表す情報elements: セクション内の要素figures: PDFに含まれる図形やイラストの情報id: 図形の一意の識別子boundingRegions: 図形の視覚的な位置情報を含む配列captions:図形に関連するテキストを示す配列
また、付随する情報として以下のようなプロパティが含まれます。
span: 全体的な読み取り順での各要素の論理的な位置
confidence:信頼度の推定値。私の手書きメモを解析した結果、confidence0.6でした。
polygon:エレメントの境界座標。画像や表などが四角形であれば、それを囲む四隅の座標が左上から時計回りに返されます。
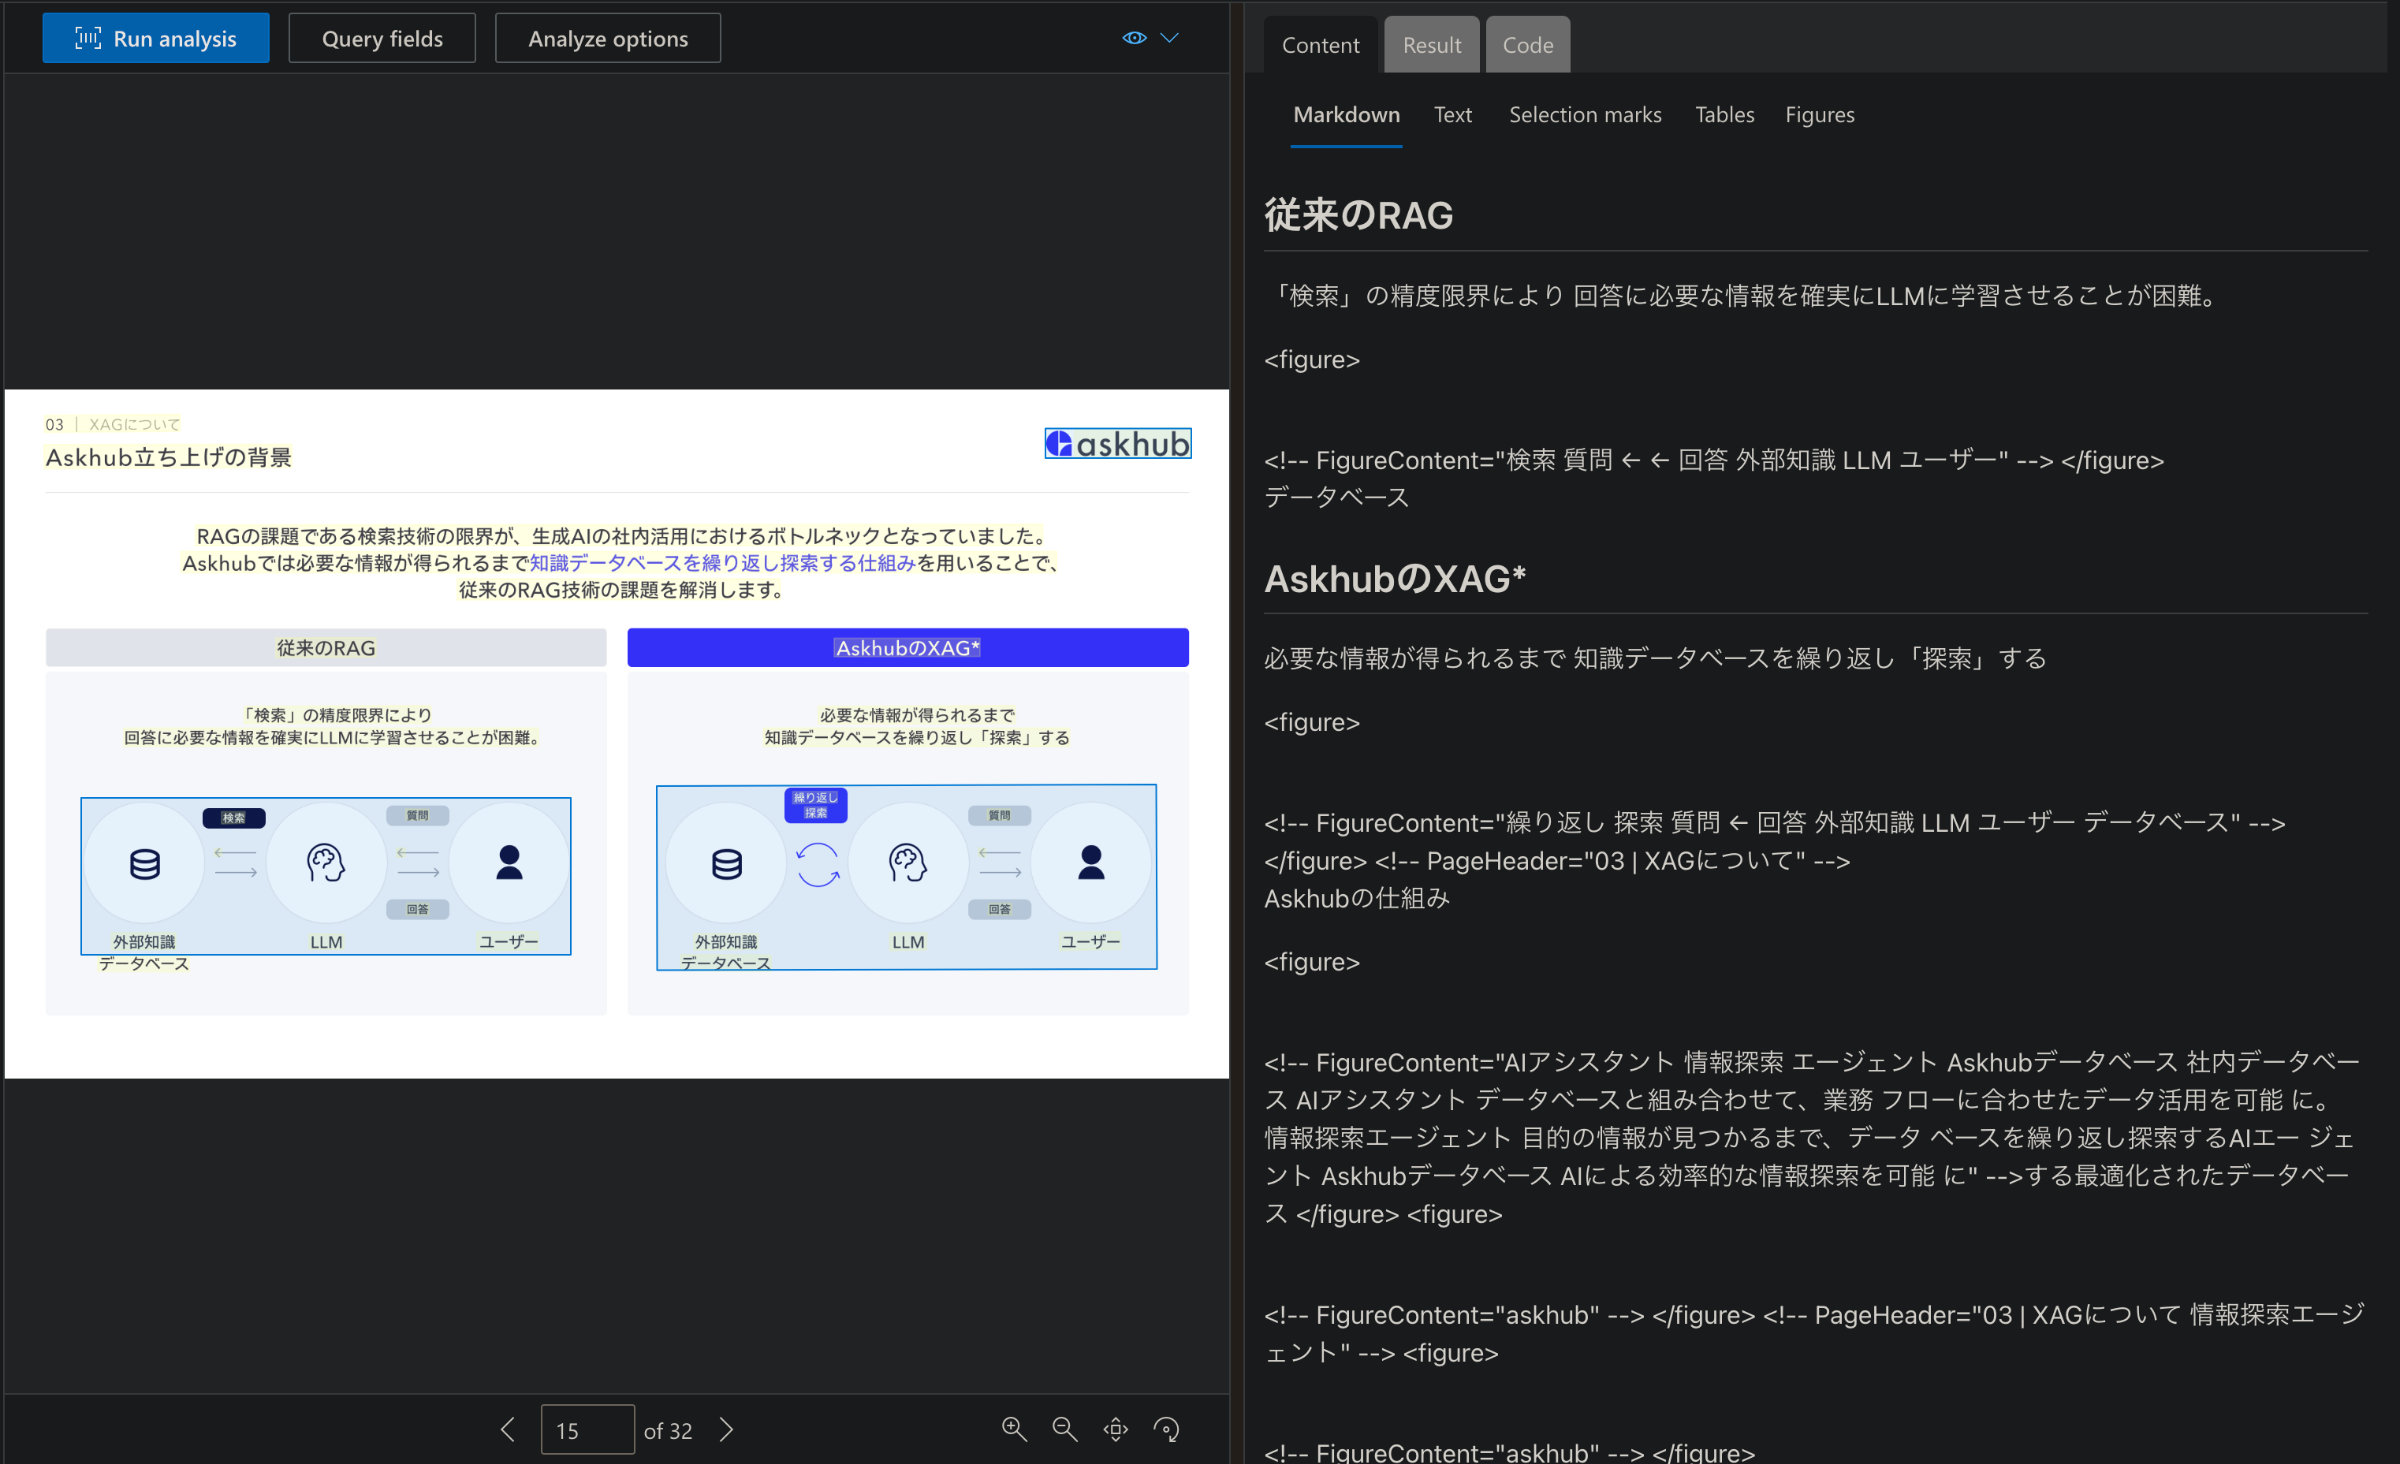
ご覧の通りDocument IntelligenceはPDFファイルの解析ツールとして非常に優秀な性能を発揮しています。 ページ、段落、表、図形などの要素を正確に識別し、それぞれの位置情報や属性を含む豊富なメタデータを生成します。特に注目すべきは、テキスト抽出の精度の高さと、表や図形の認識能力です。
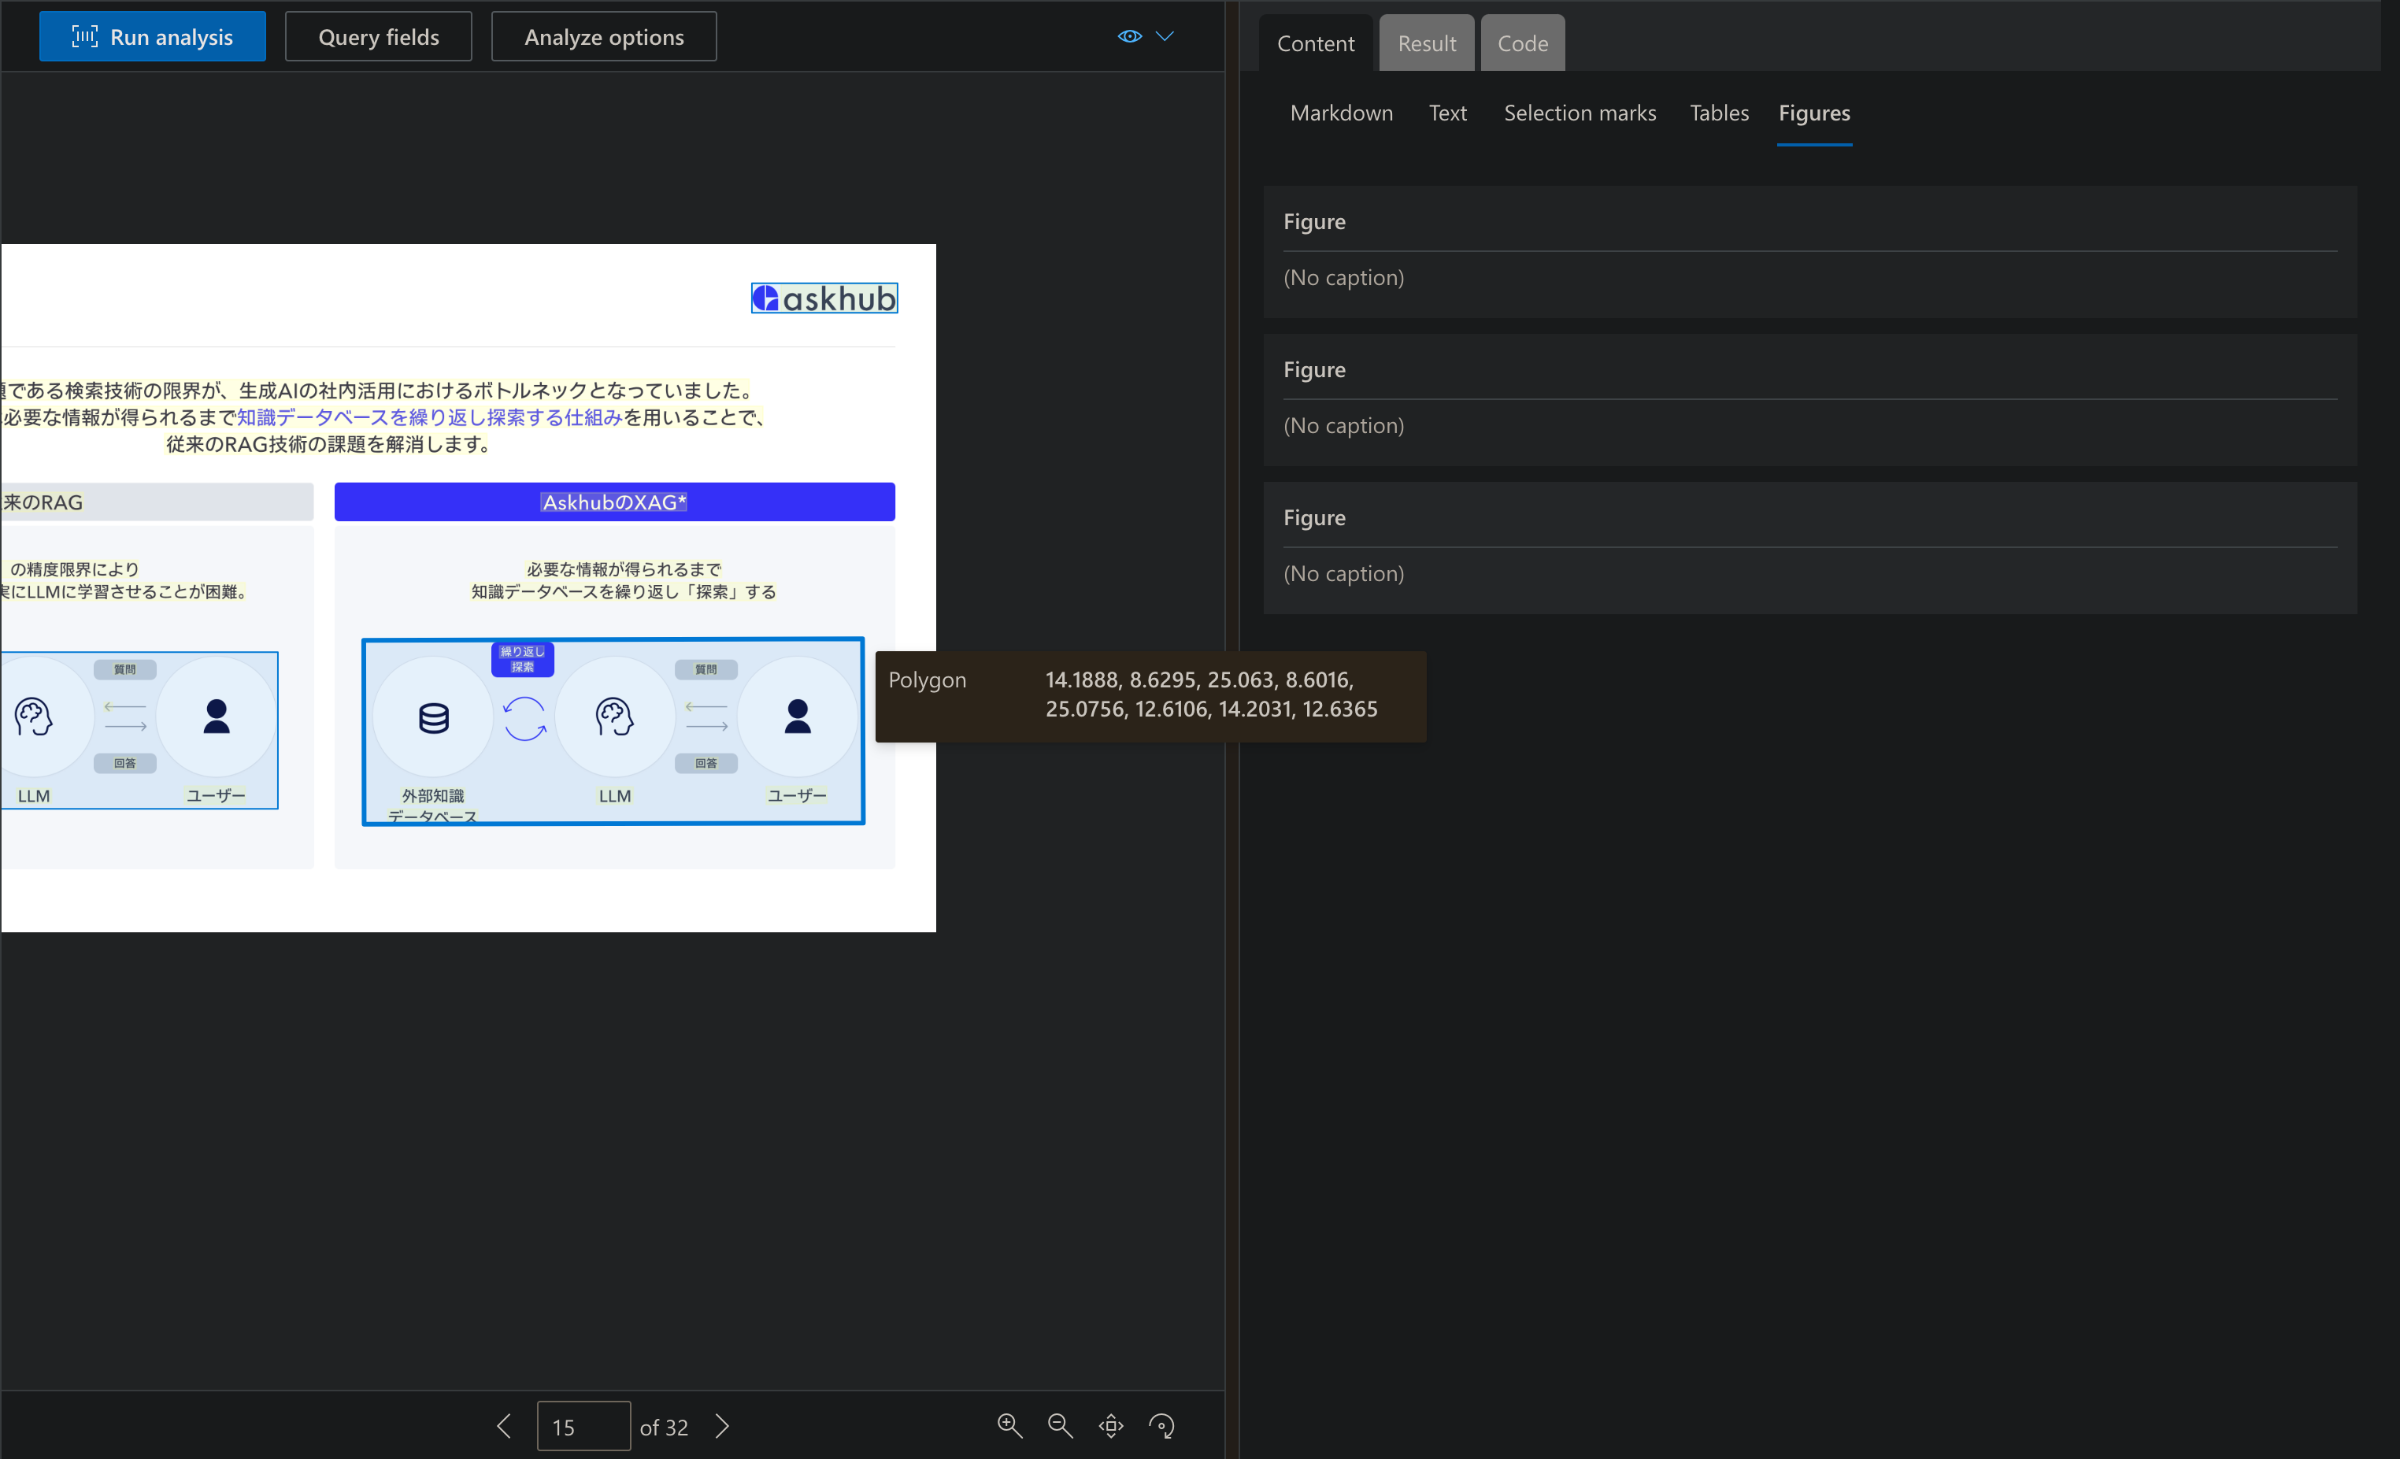
また、文書の論理的構造を把握する能力も有しており、様々なビジネスシーンでの活用が期待できると言えるでしょう。 AI-OCRを使用しているため、以下のように意味のあるブロックとして画像を切り出してくれるポイントも素晴らしいですね。
それではその他のファイル形式の検証に移っていきましょう。
PowerPoint(.pptx)
次にPowerPointの検証です。
私のドライブをひっくり返しましたがまともなpptxドキュメントが見つからなかったので、今回はMicrosoft365上の”最適な PowerPoint プレゼンテーション テンプレートを見つける”ページからテンプレートを拝借することにします。
早速ちょうどいいものが見つかりました。
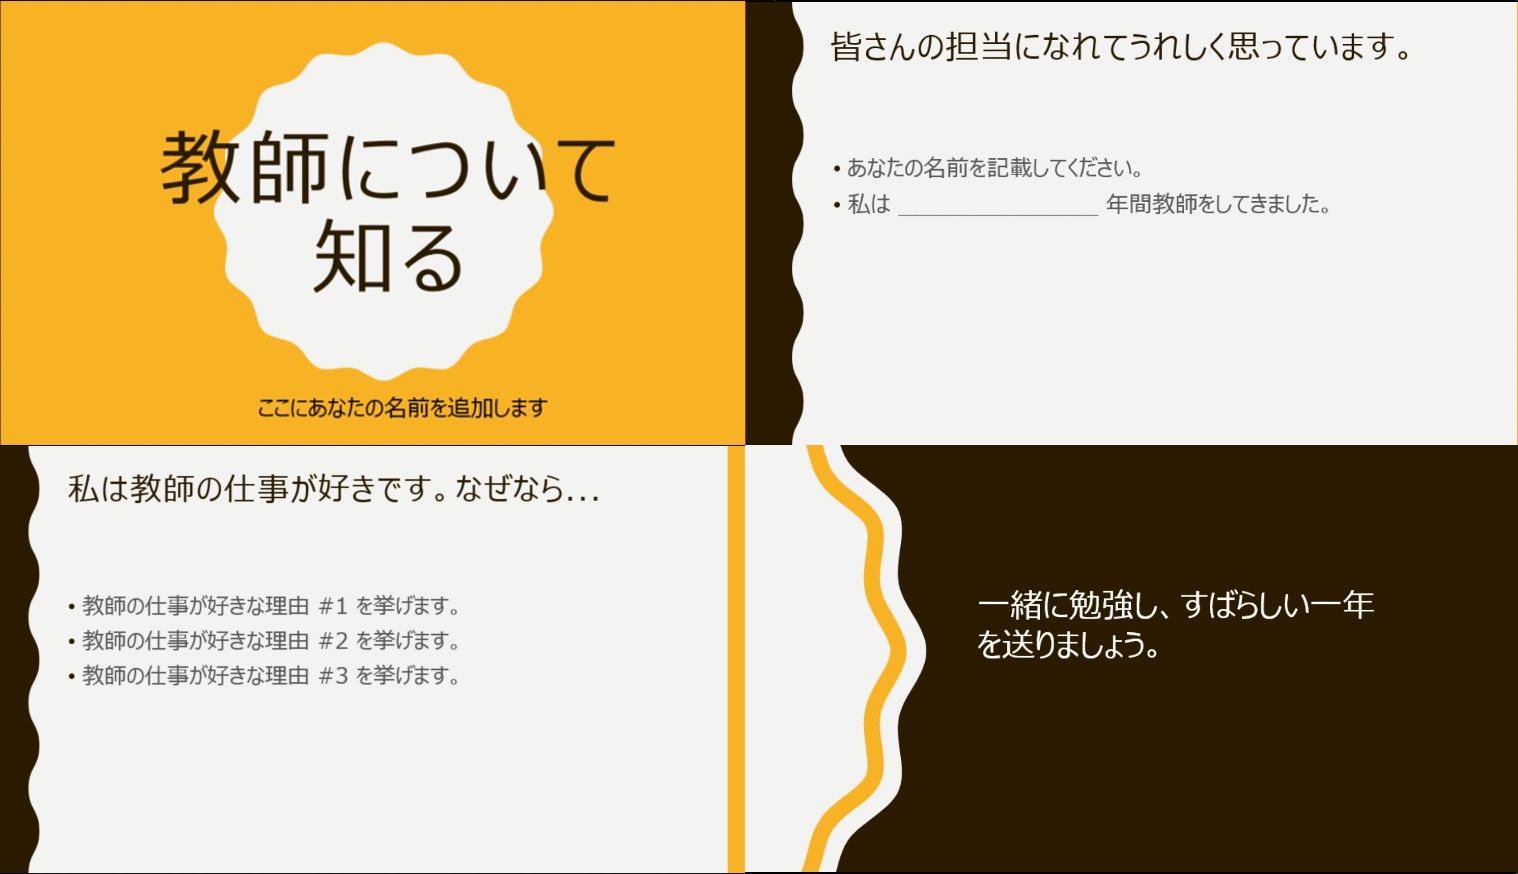
これぞPowerPointといった資料ですね。
小学校の担任の教師がちょうど全く同じようなPowerPointを使用して挨拶をしてくれたことが思い出されます。 「先生は大人だしなんでもできてすごいなぁ」とその時分私は感じた訳ですが、「皆さんの担当になれてうれしい」や「教師の仕事が好きです」という言葉が”テンプレート”として存在するのは物悲しさすら覚えてしまいますね。
気を取り直して本題の検証に移ります。
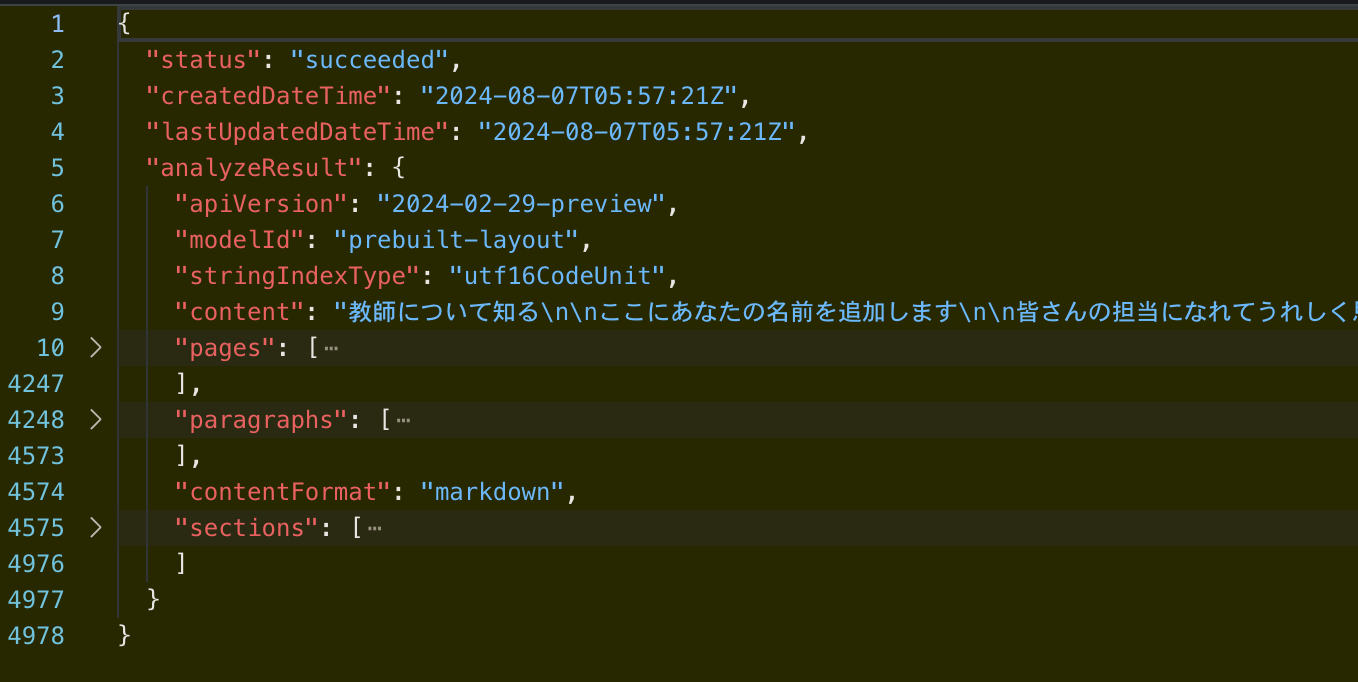
こちらが得られたレスポンスとなっておりますが、心なしかスッキリしているように見受けられると思います。 そう、PowerPointはfigure(図画)の処理に対応していないのです。 同じMicrosoftのサービスですので頑張って欲しいものですが、できないものはできないのでしょうがないですね。
こちらは余談ですが、AskhubではPowerPointをアップロードおよび高精度解析が可能です。 ネタバラシをすると裏側でpptxをPdfに変換する処理が走っている訳なのですが、スタックポイントがいくつかあります。しかし今回の趣旨とはズレるので割愛。
詳細を見たところテキスト自体は綺麗に抜けていますが、図画が抜けないにも関わらずpptxをコストのかかるDocument Intelligenceにかけることが果たしてベストな選択肢なのかどうかは一考の余地があるでしょう。
テキストベースのドキュメント
Word文書(.docx)
ちょうどイラストと表形式のデータが載っているこちらのWordファイルで検証します。
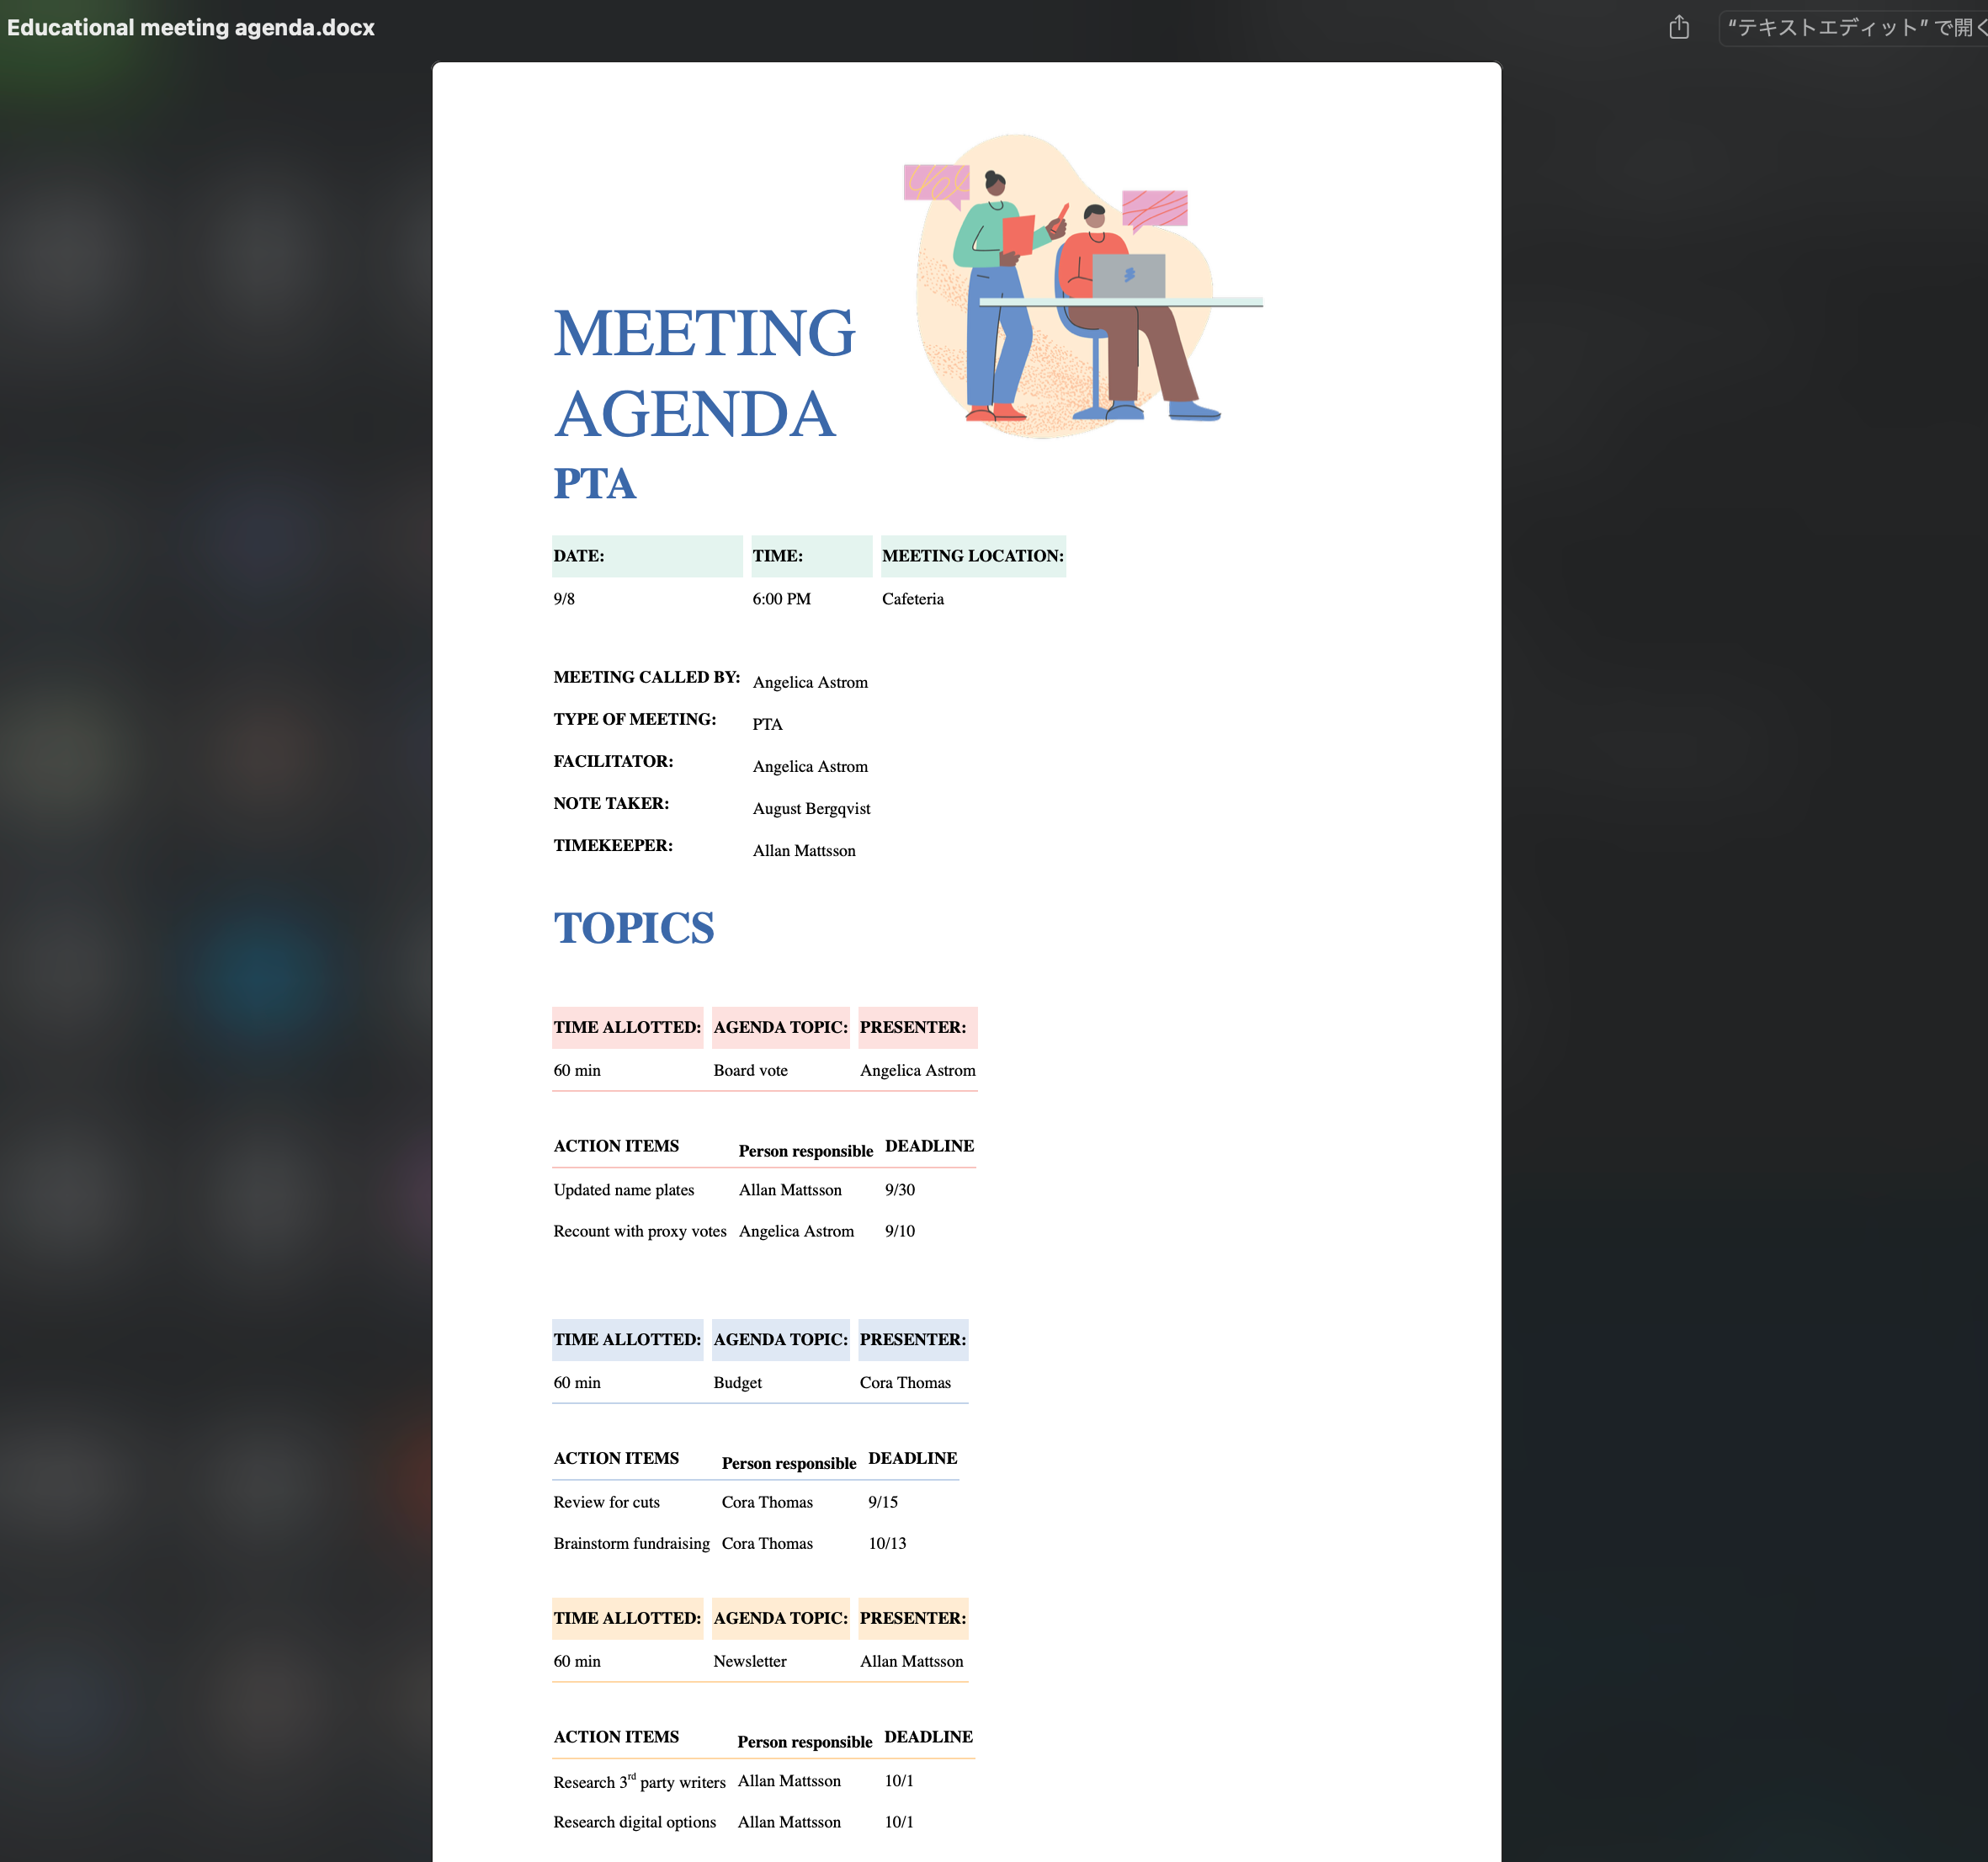
早速解析にかけると、
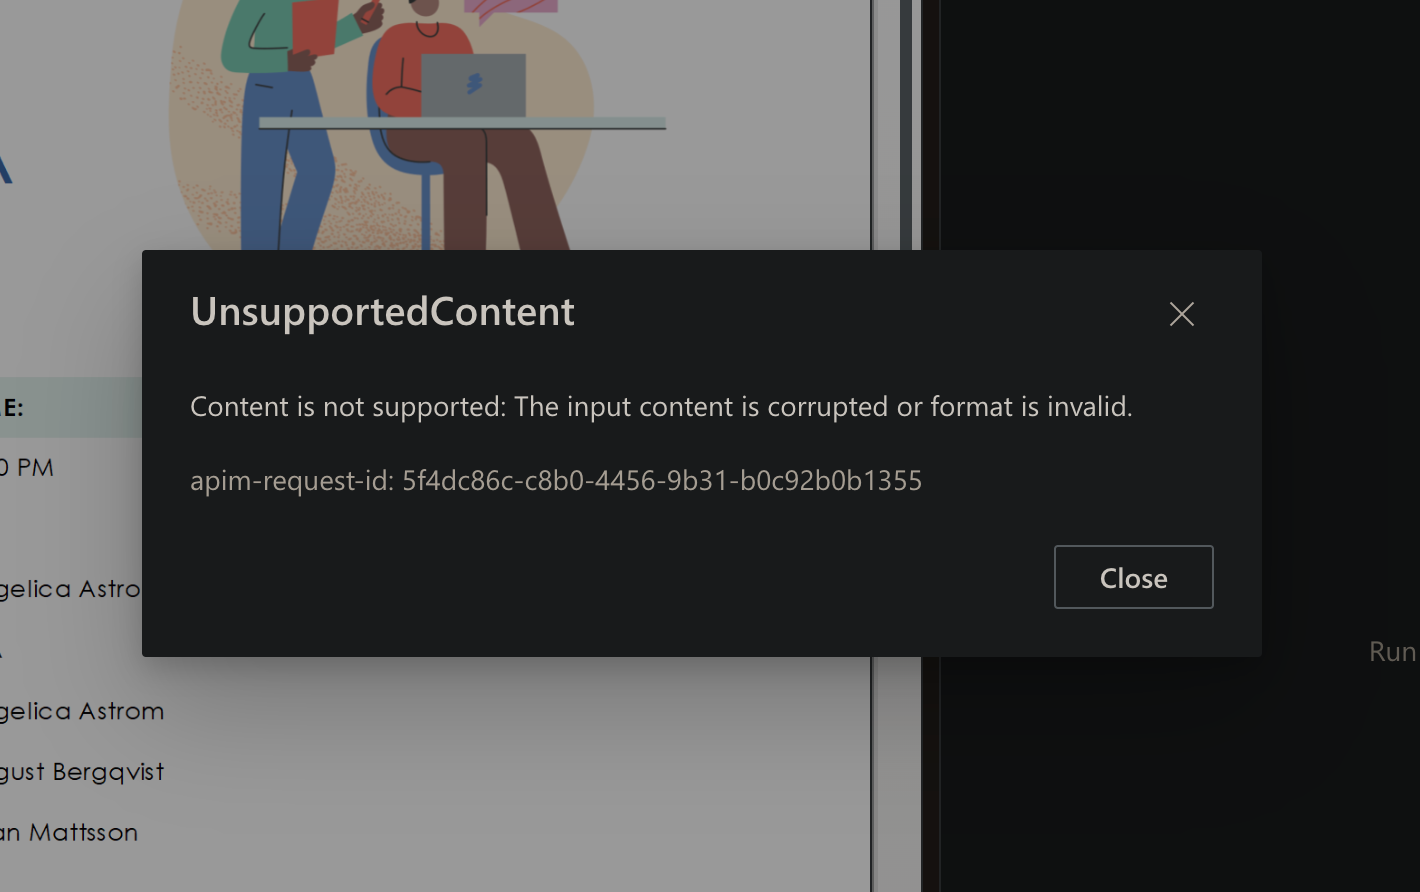
コンテンツをサポートしていないとのエラーが出ます。 Document Intelligenceは.doc形式の解析をサポートしていないことは知っていますが、今回投げているのは.docxファイル。 その後数回の環境を変えたリトライを行いましたが、同様のレスポンスが帰ってきました。 挙動はちと?不安定なようです。
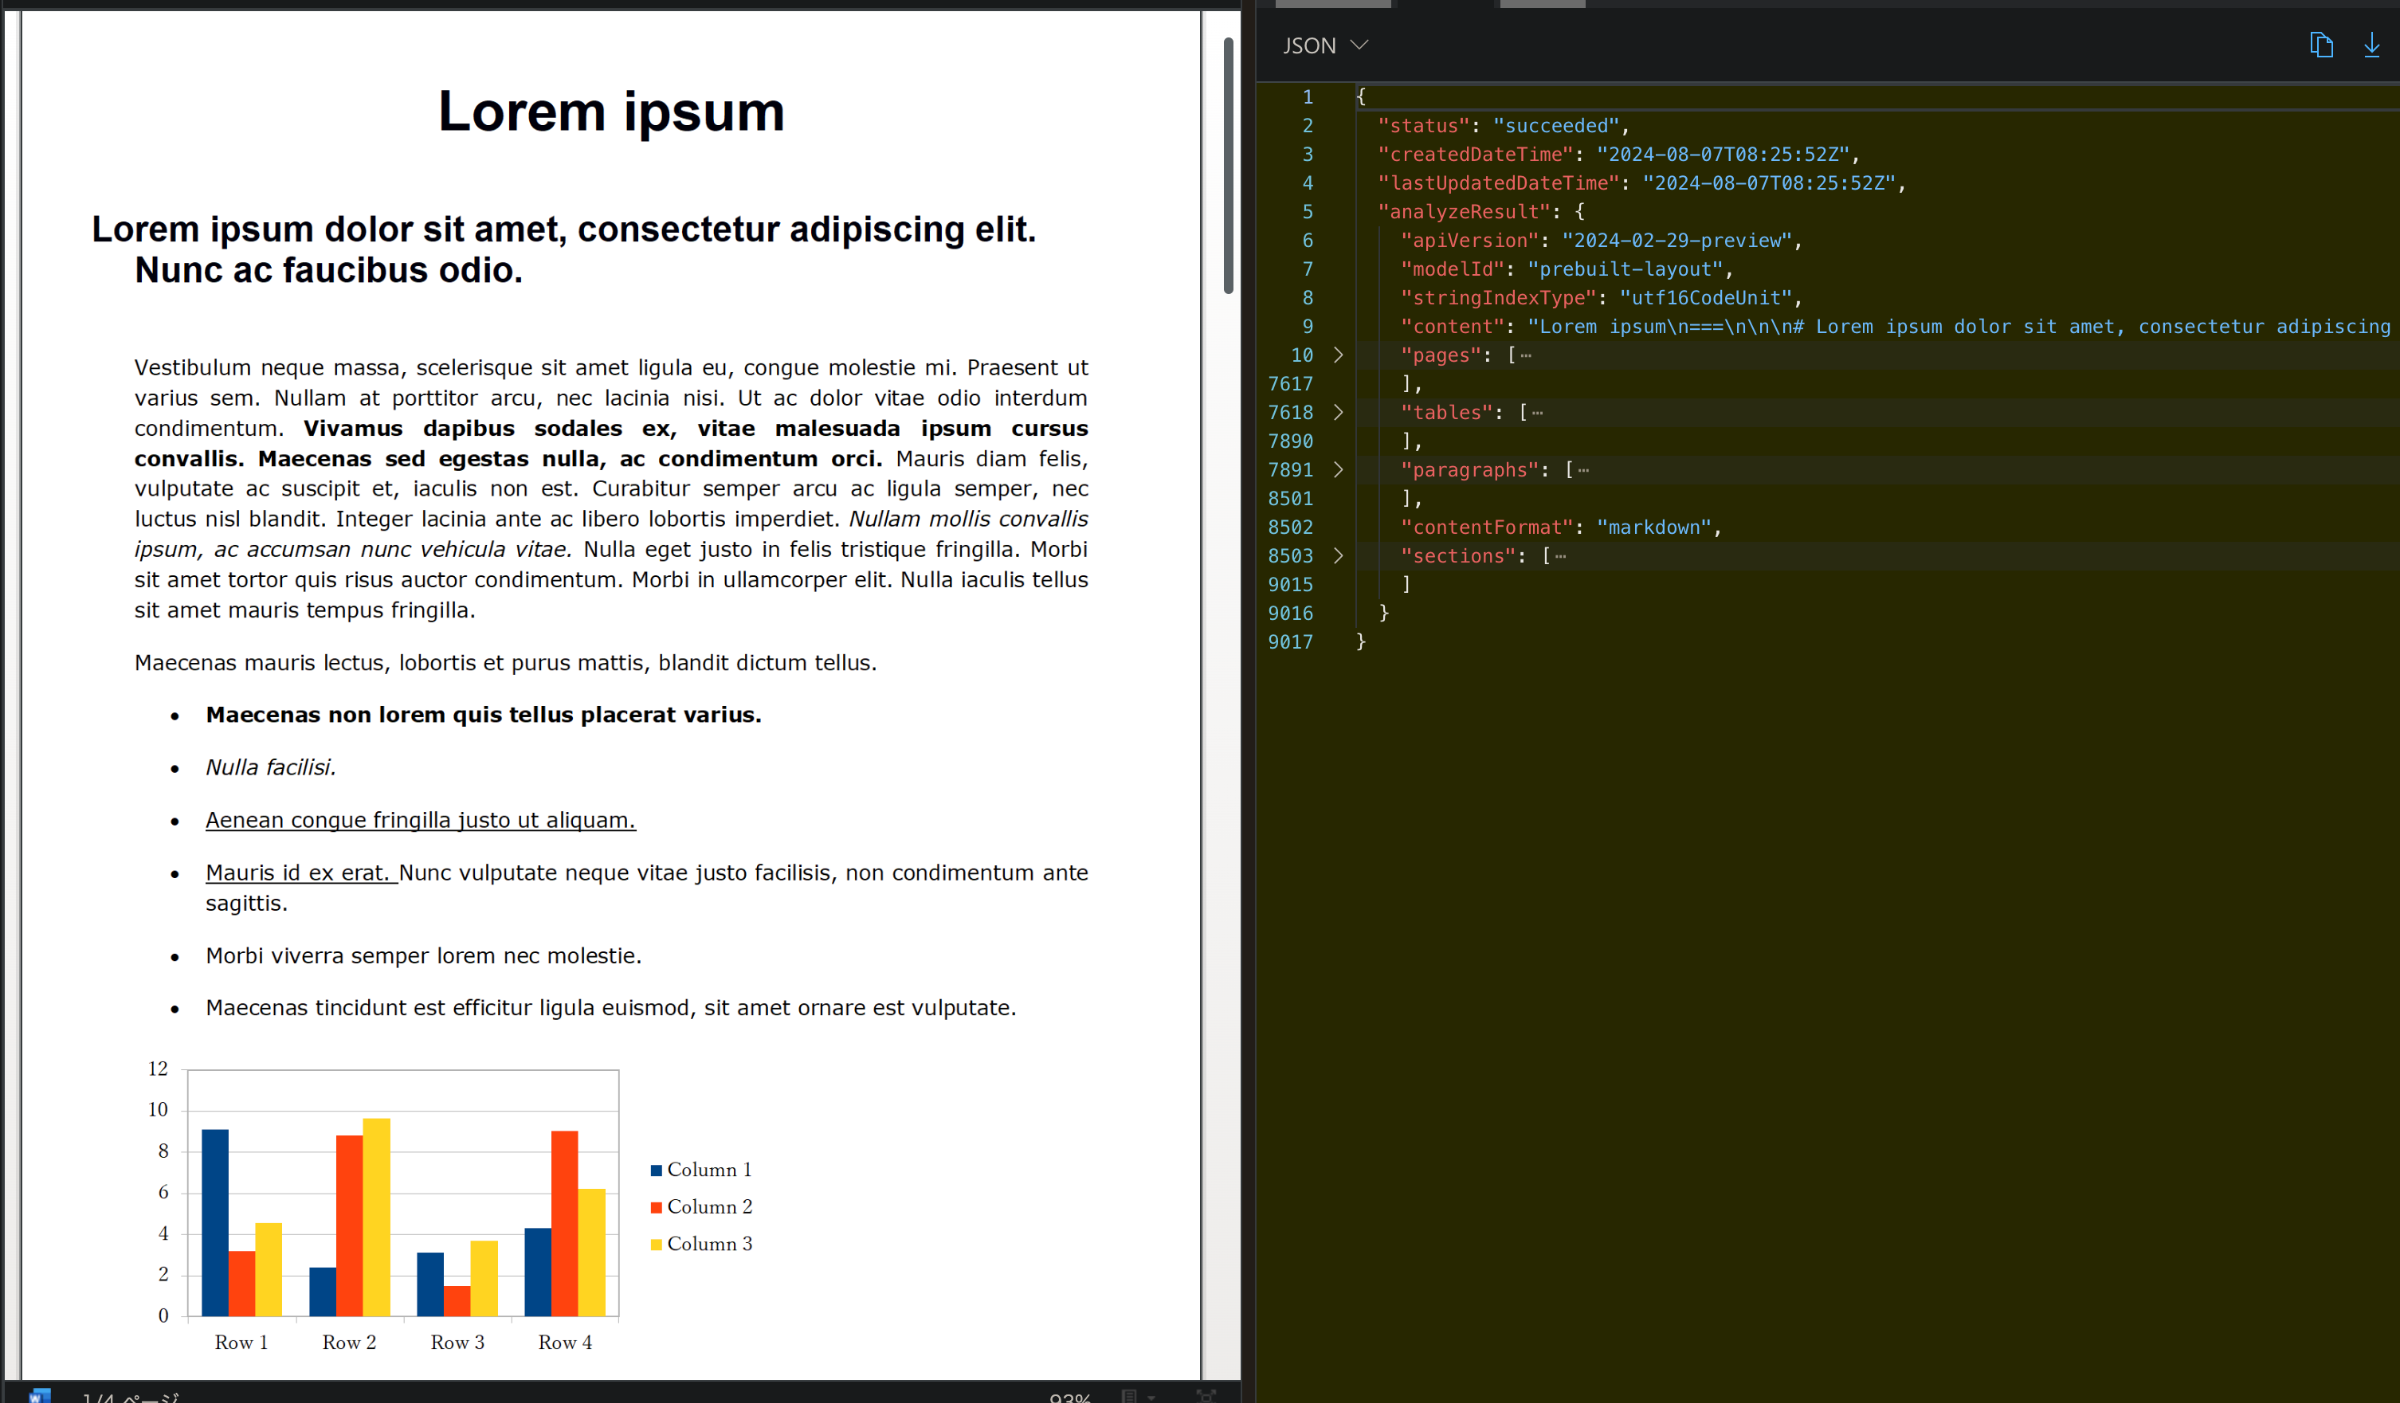
まるでDocumentIntelligenceの精度を試すためだけに存在するかのようなこちらのWordファイルはsucceededが帰ってきます。 表データやテキストは綺麗に抜けていますが、やはり1度目のエラーが気になります。
追って検証を進めましょう。
その後10個ほどのwordファイルを検証しましたが、全て解析可能でした。
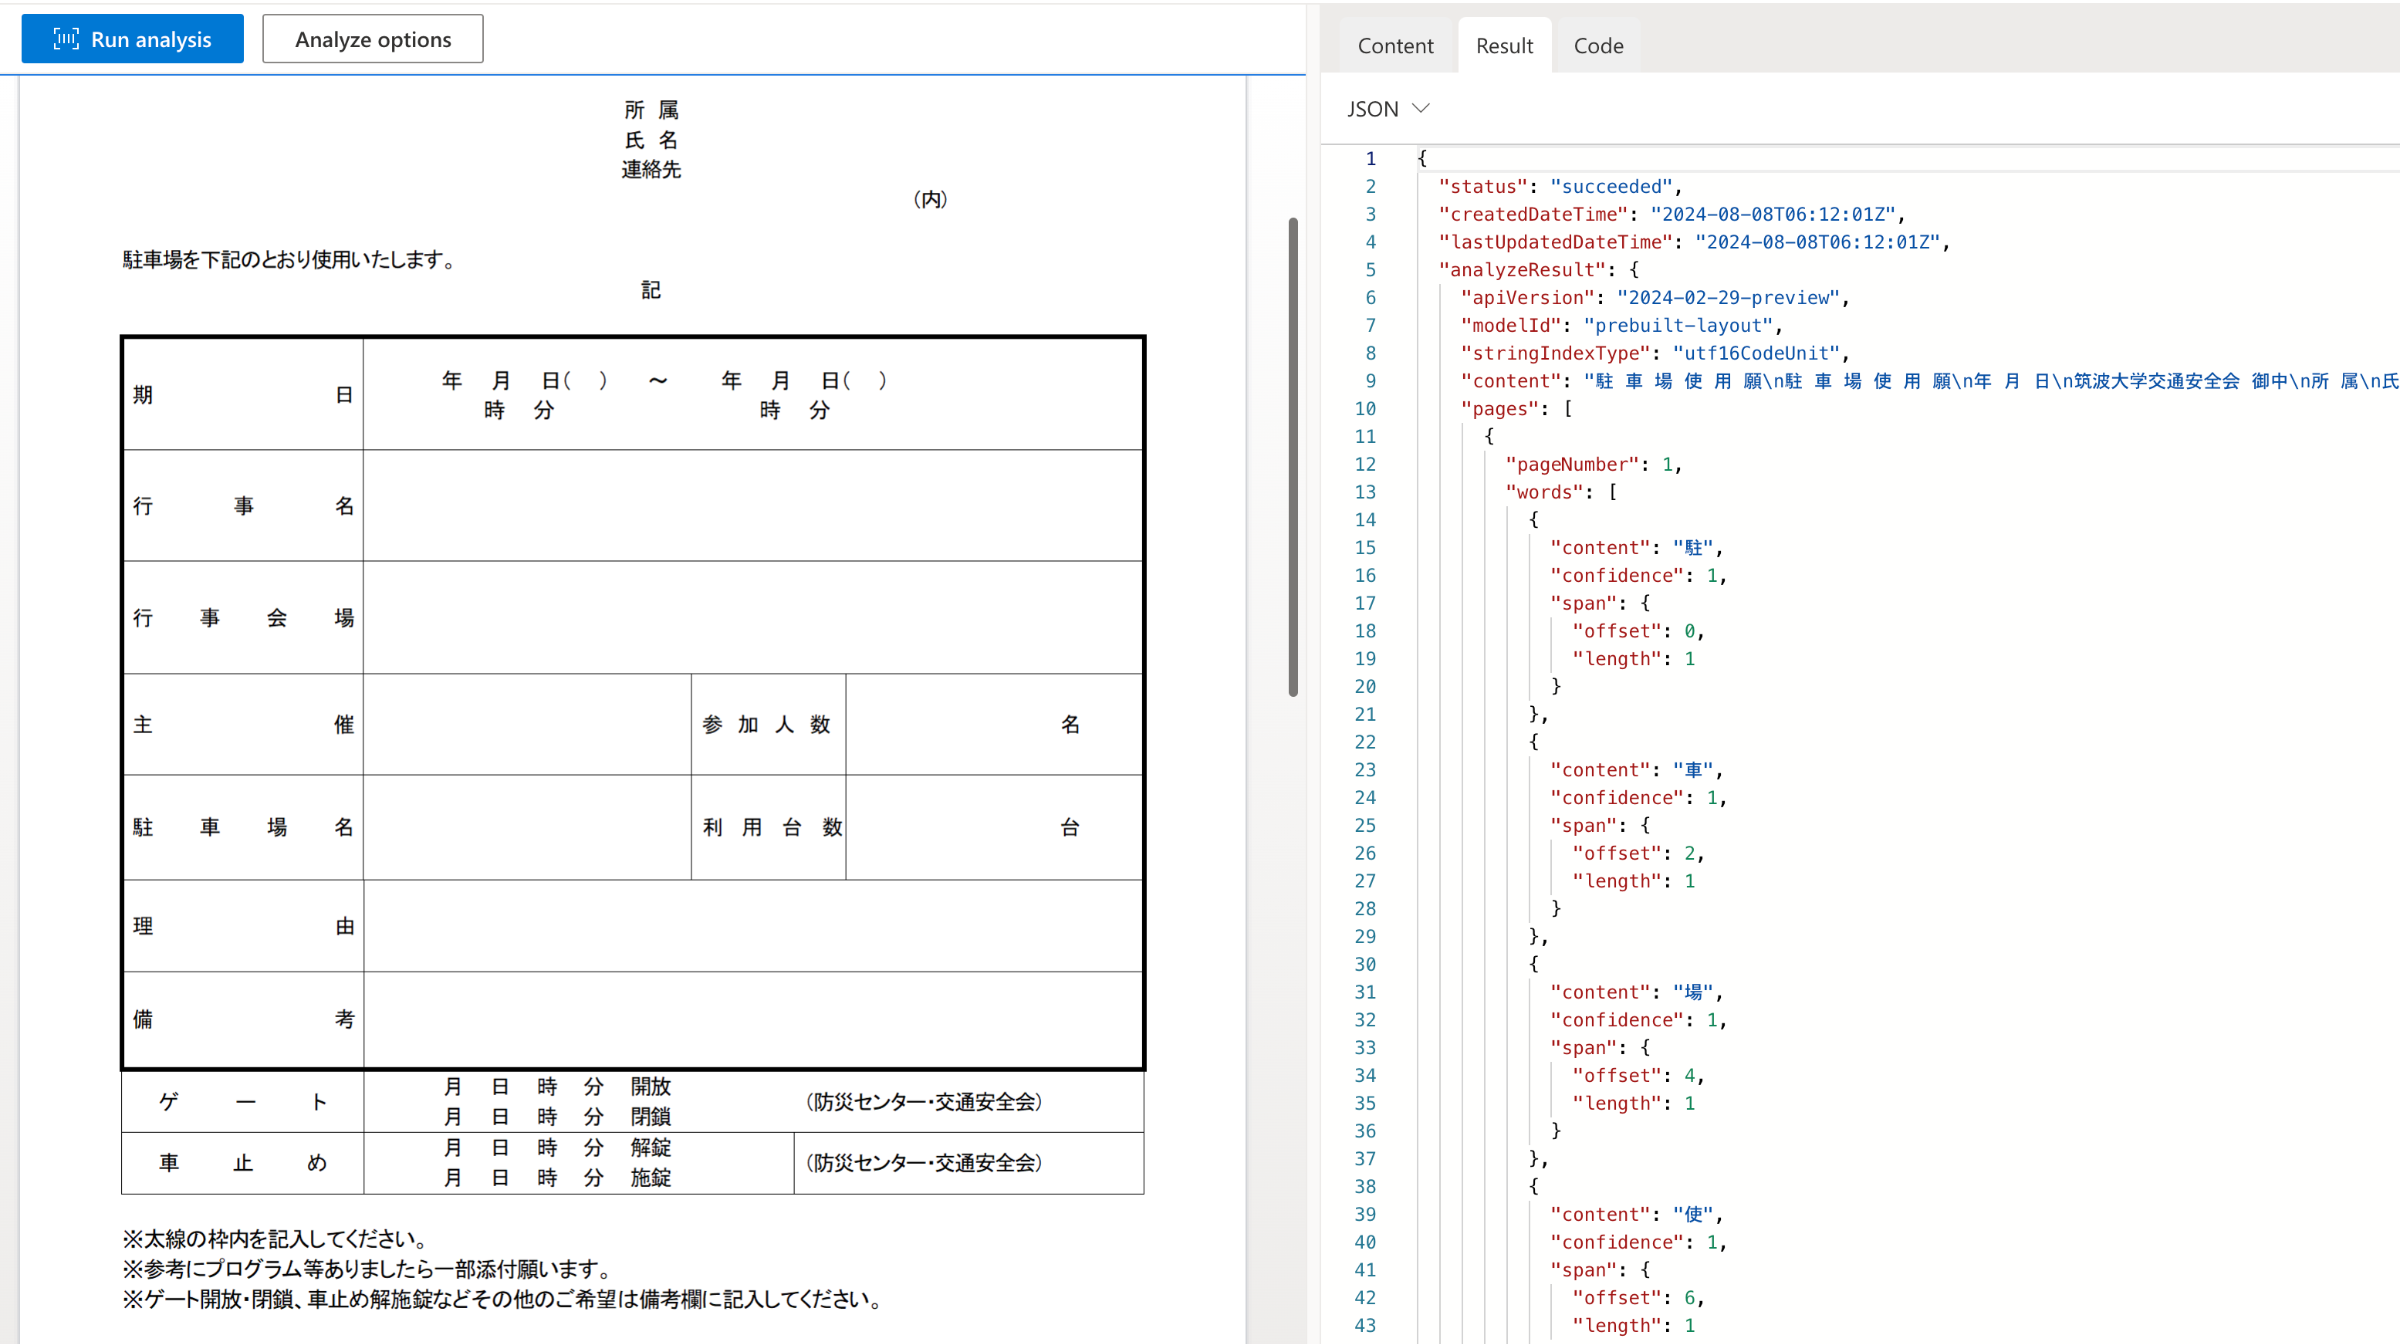
ますますはじめに試したWordのエラーが気になりますが、今回はこれ以上の深追いはやめておきます。 Wordもpdf化して読み込ませるのがベストプラクティスのようです。
HTML(.html)
検証するために最適なhtmlファイルをClaudeのArtifactに生成させましょう。
’’’ htmlの限界に挑戦して お題はITとAIとイノベーション ’’’
あっという間に生成されたこの珍妙なhtmlを投げてみましょう。
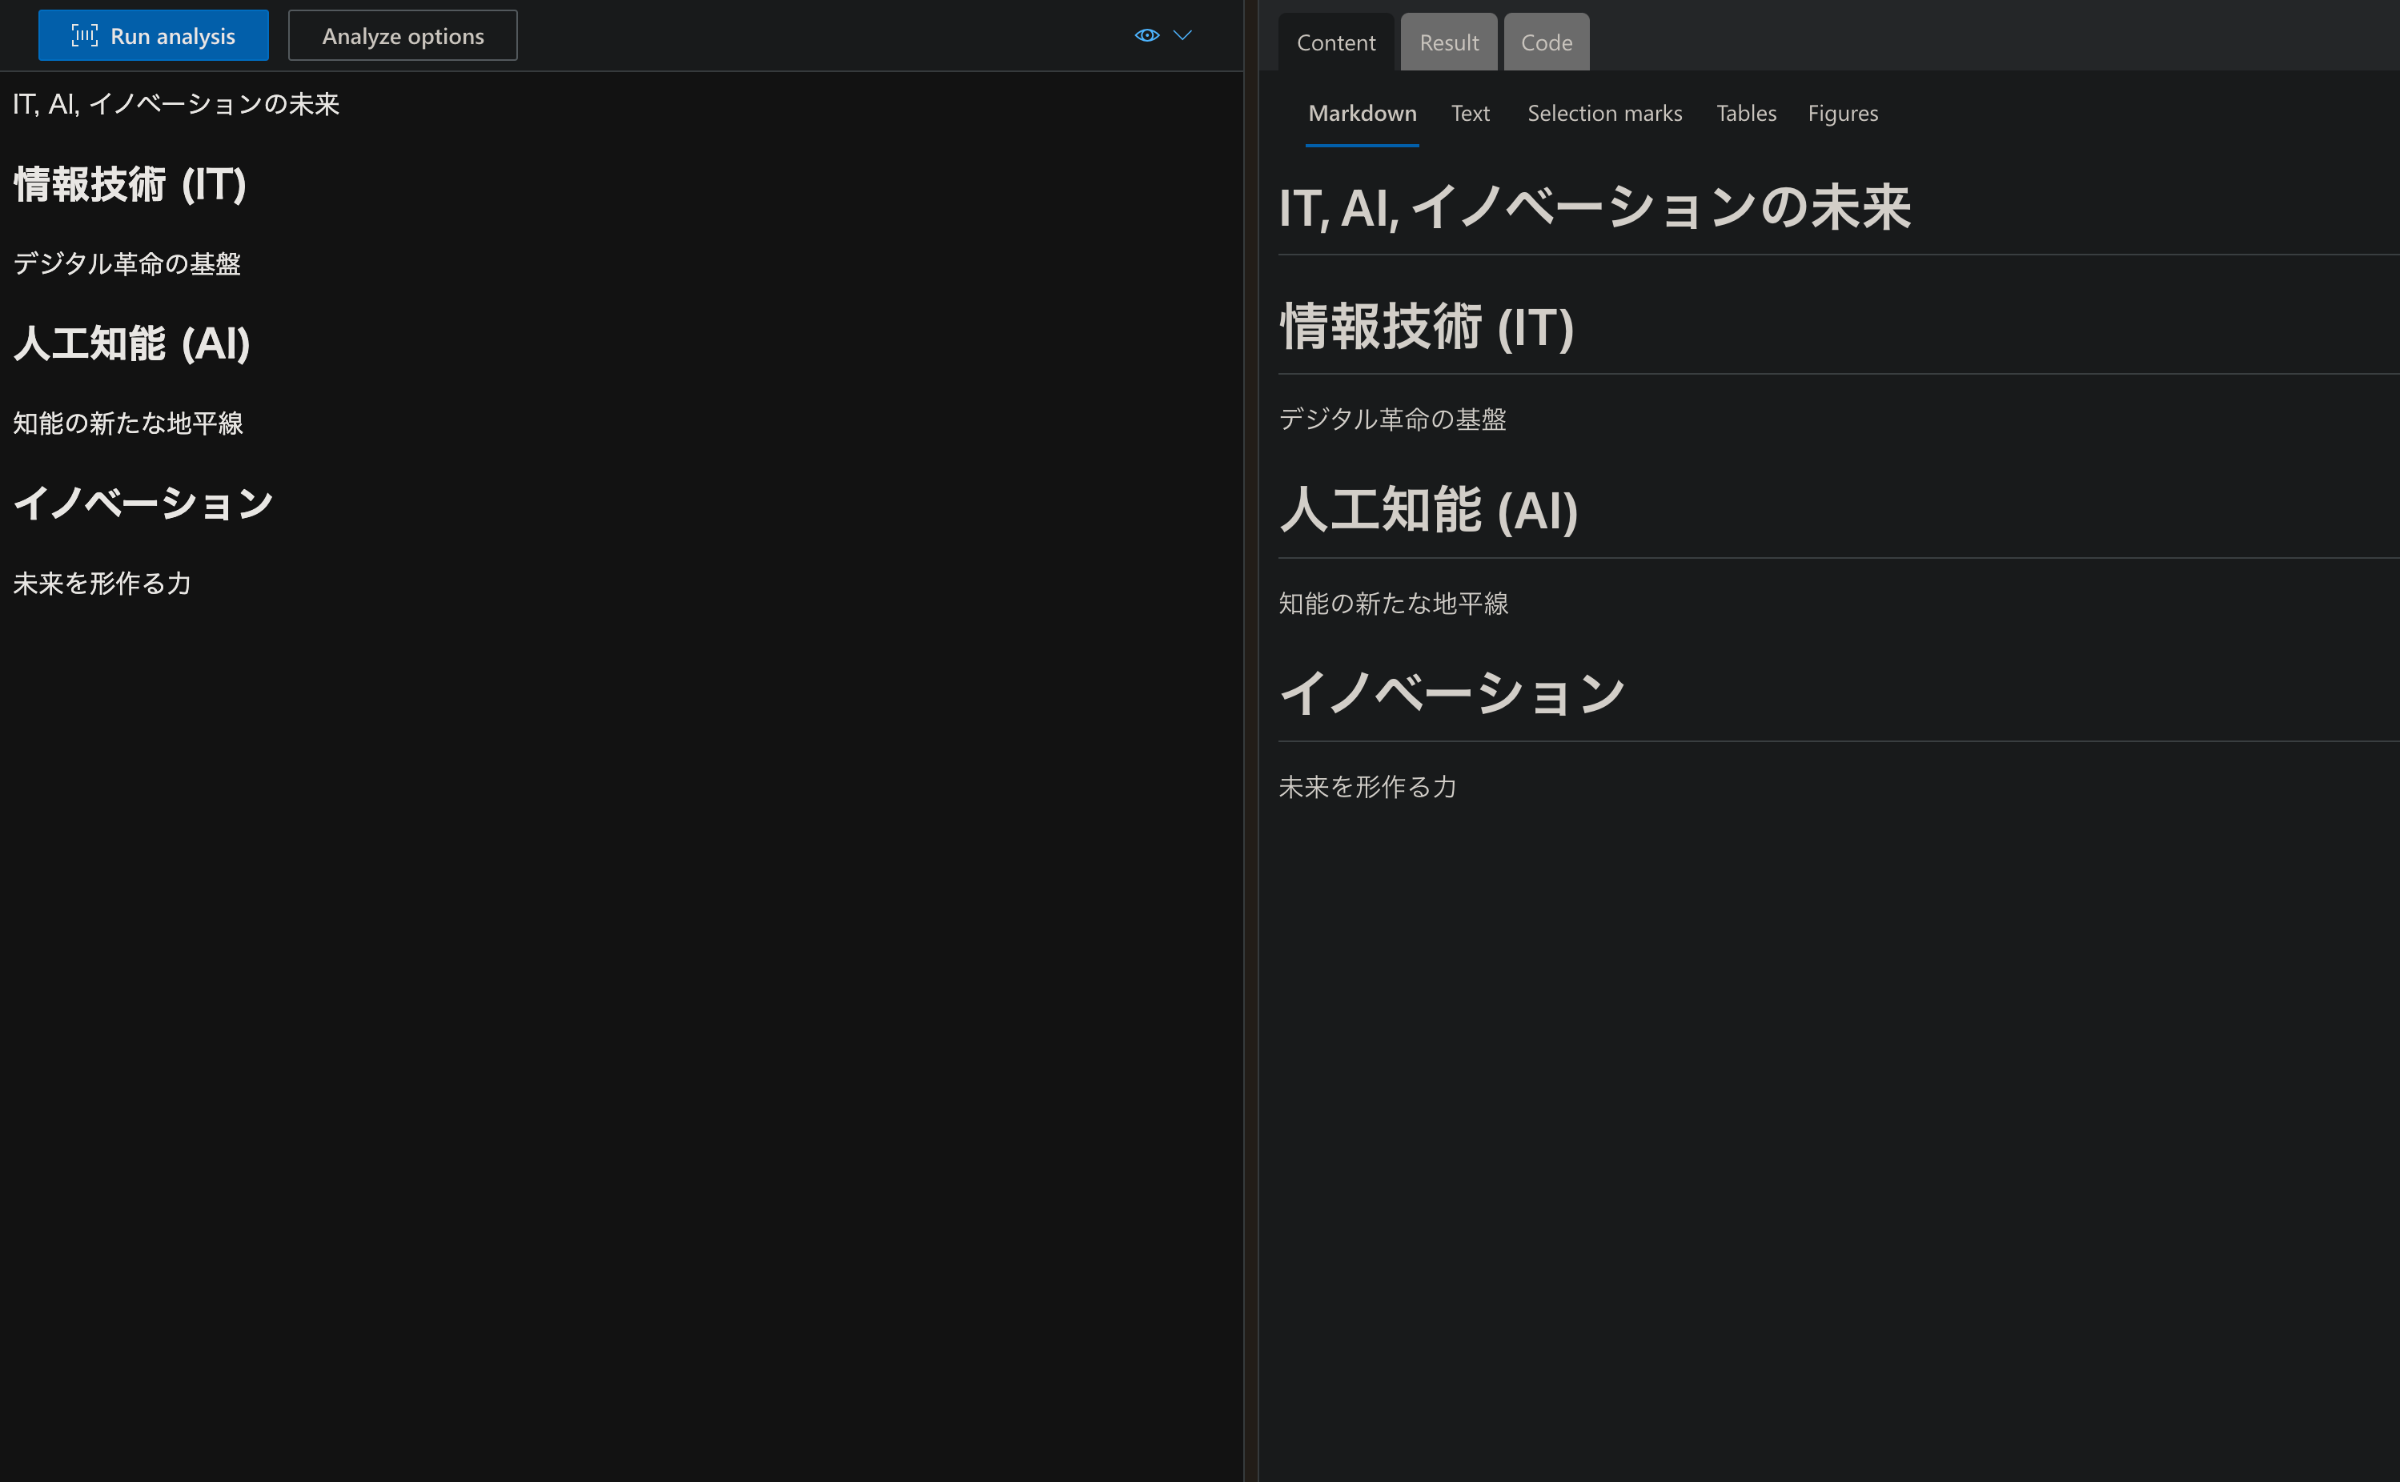
はい。そうですよね。
htmlも画像の抽出には対応していません。つまり今行ったのはhtmlからテキストを引き抜く作業ということです。
Document Intelligenceは、複雑な文書から情報を抽出するための強力なAIツールです。請求書、契約書、手書きの文書など、構造化されていない文書から重要なデータを取り出すのが主なユースケースです。
一方、HTMLはウェブページの構造を定義するためのマークアップ言語です。そう。すでに構造化されているんです。
Azure Document Intelligenceは素晴らしいサービスですが、無料ではありません。HTMLの解析にこれを使用するのは、東京から品川へ行くのに、東海道新幹線のチケットを購入するようなものです。確かに目的地には着きますが、山手線で十分だったはずです。 requestsライブラリやBeautifulSoupなどの軽量ツールは、この場合の山手線です。費用対効果が高く、目的を十分に果たせます。 これ以上弊社のキャッシュを溶かしてしまう前に次の検証に移りたいと思います。
表形式のデータ
Excelスプレッドシート(.xlsx, .xls)
テーブル形式のデータの抽出が得意なDocument Intelligence、安心してxlsxファイルを投げてみます。
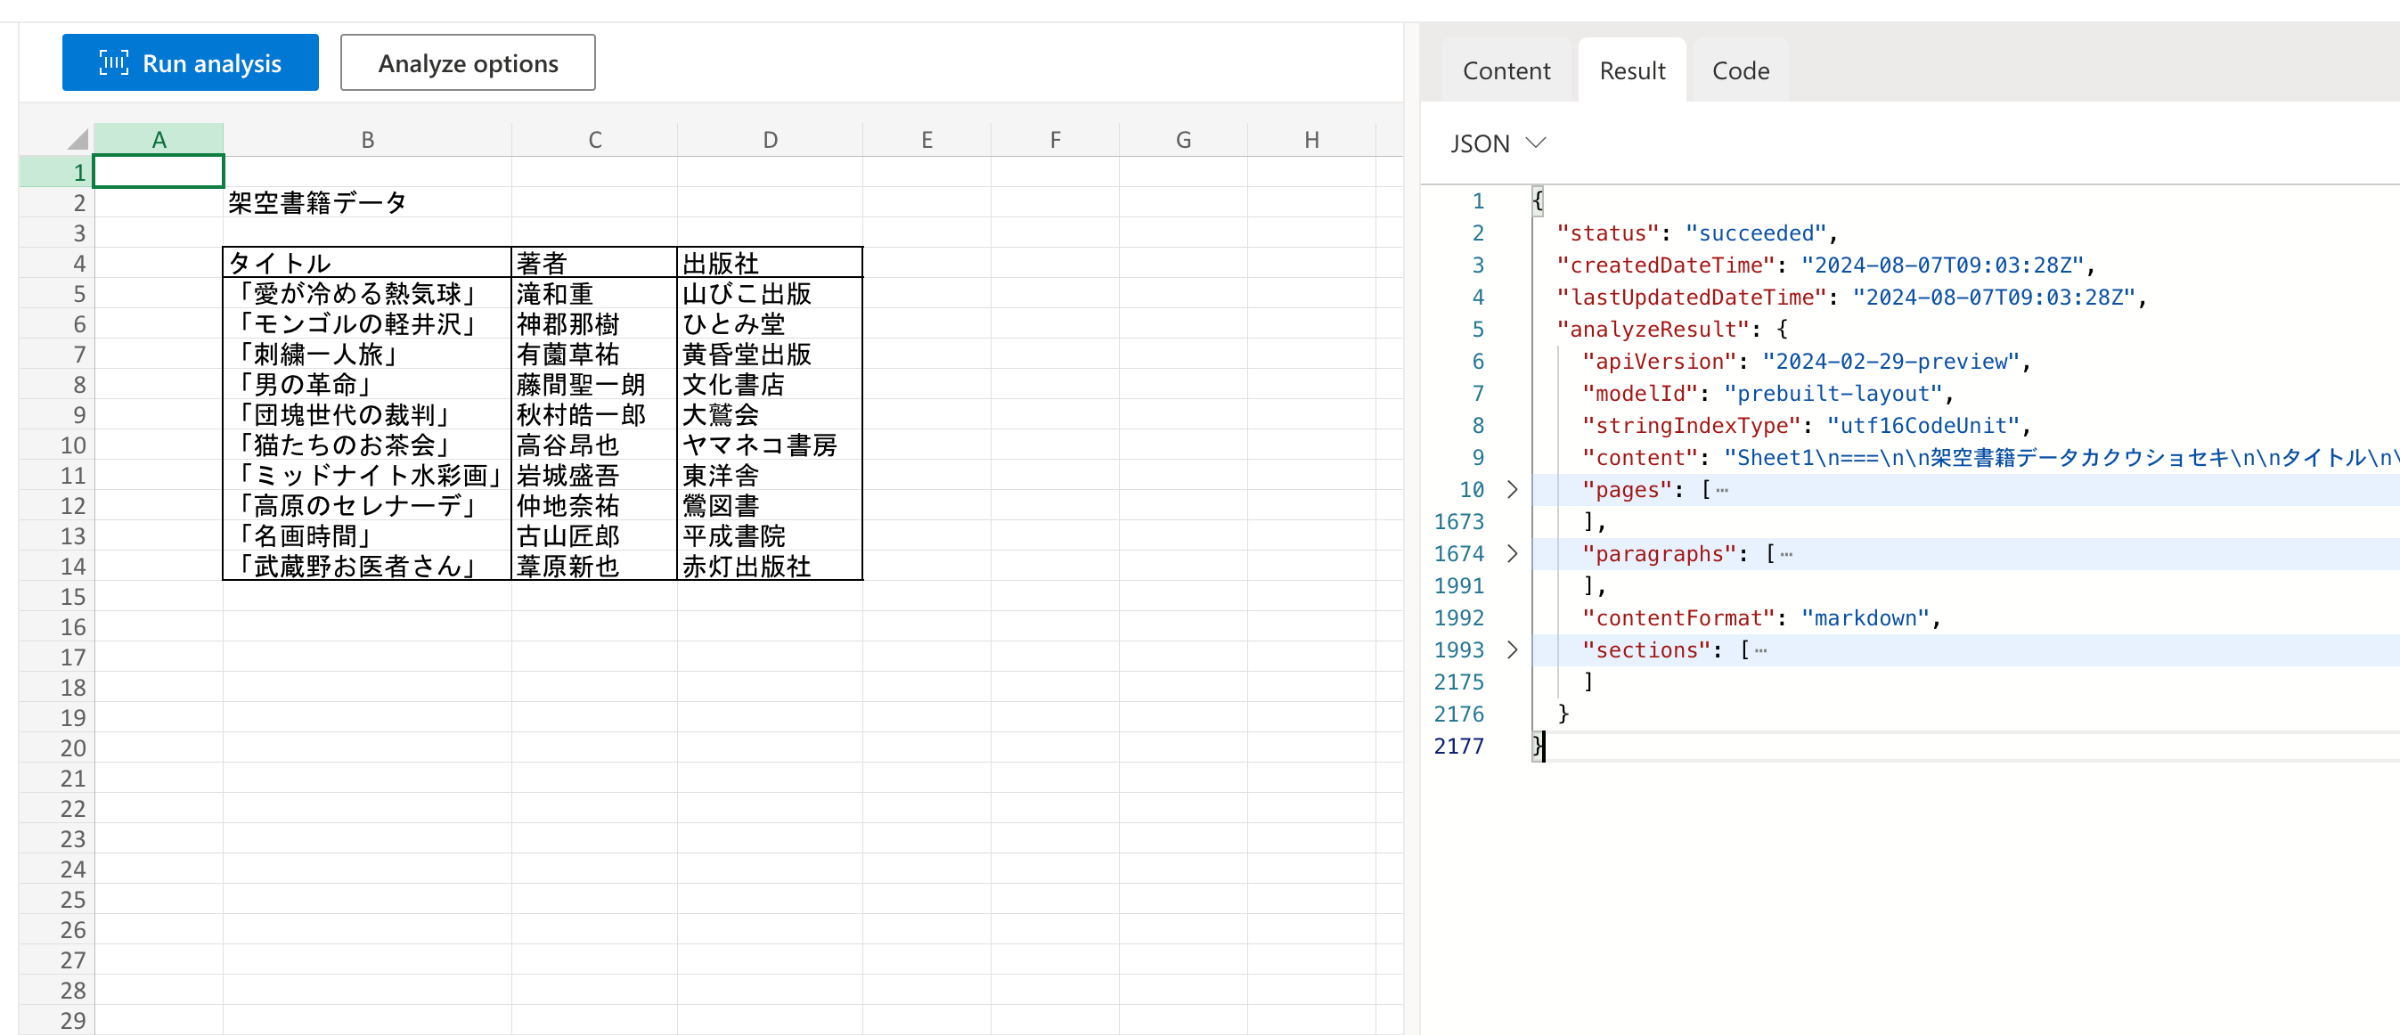
なんとレスポンスにTablesがありません。
No table was found on current page. Switch to another page to see more results.
だそうです。 まさかとは思いましたが罫線を無視してテキストとして捉えております。
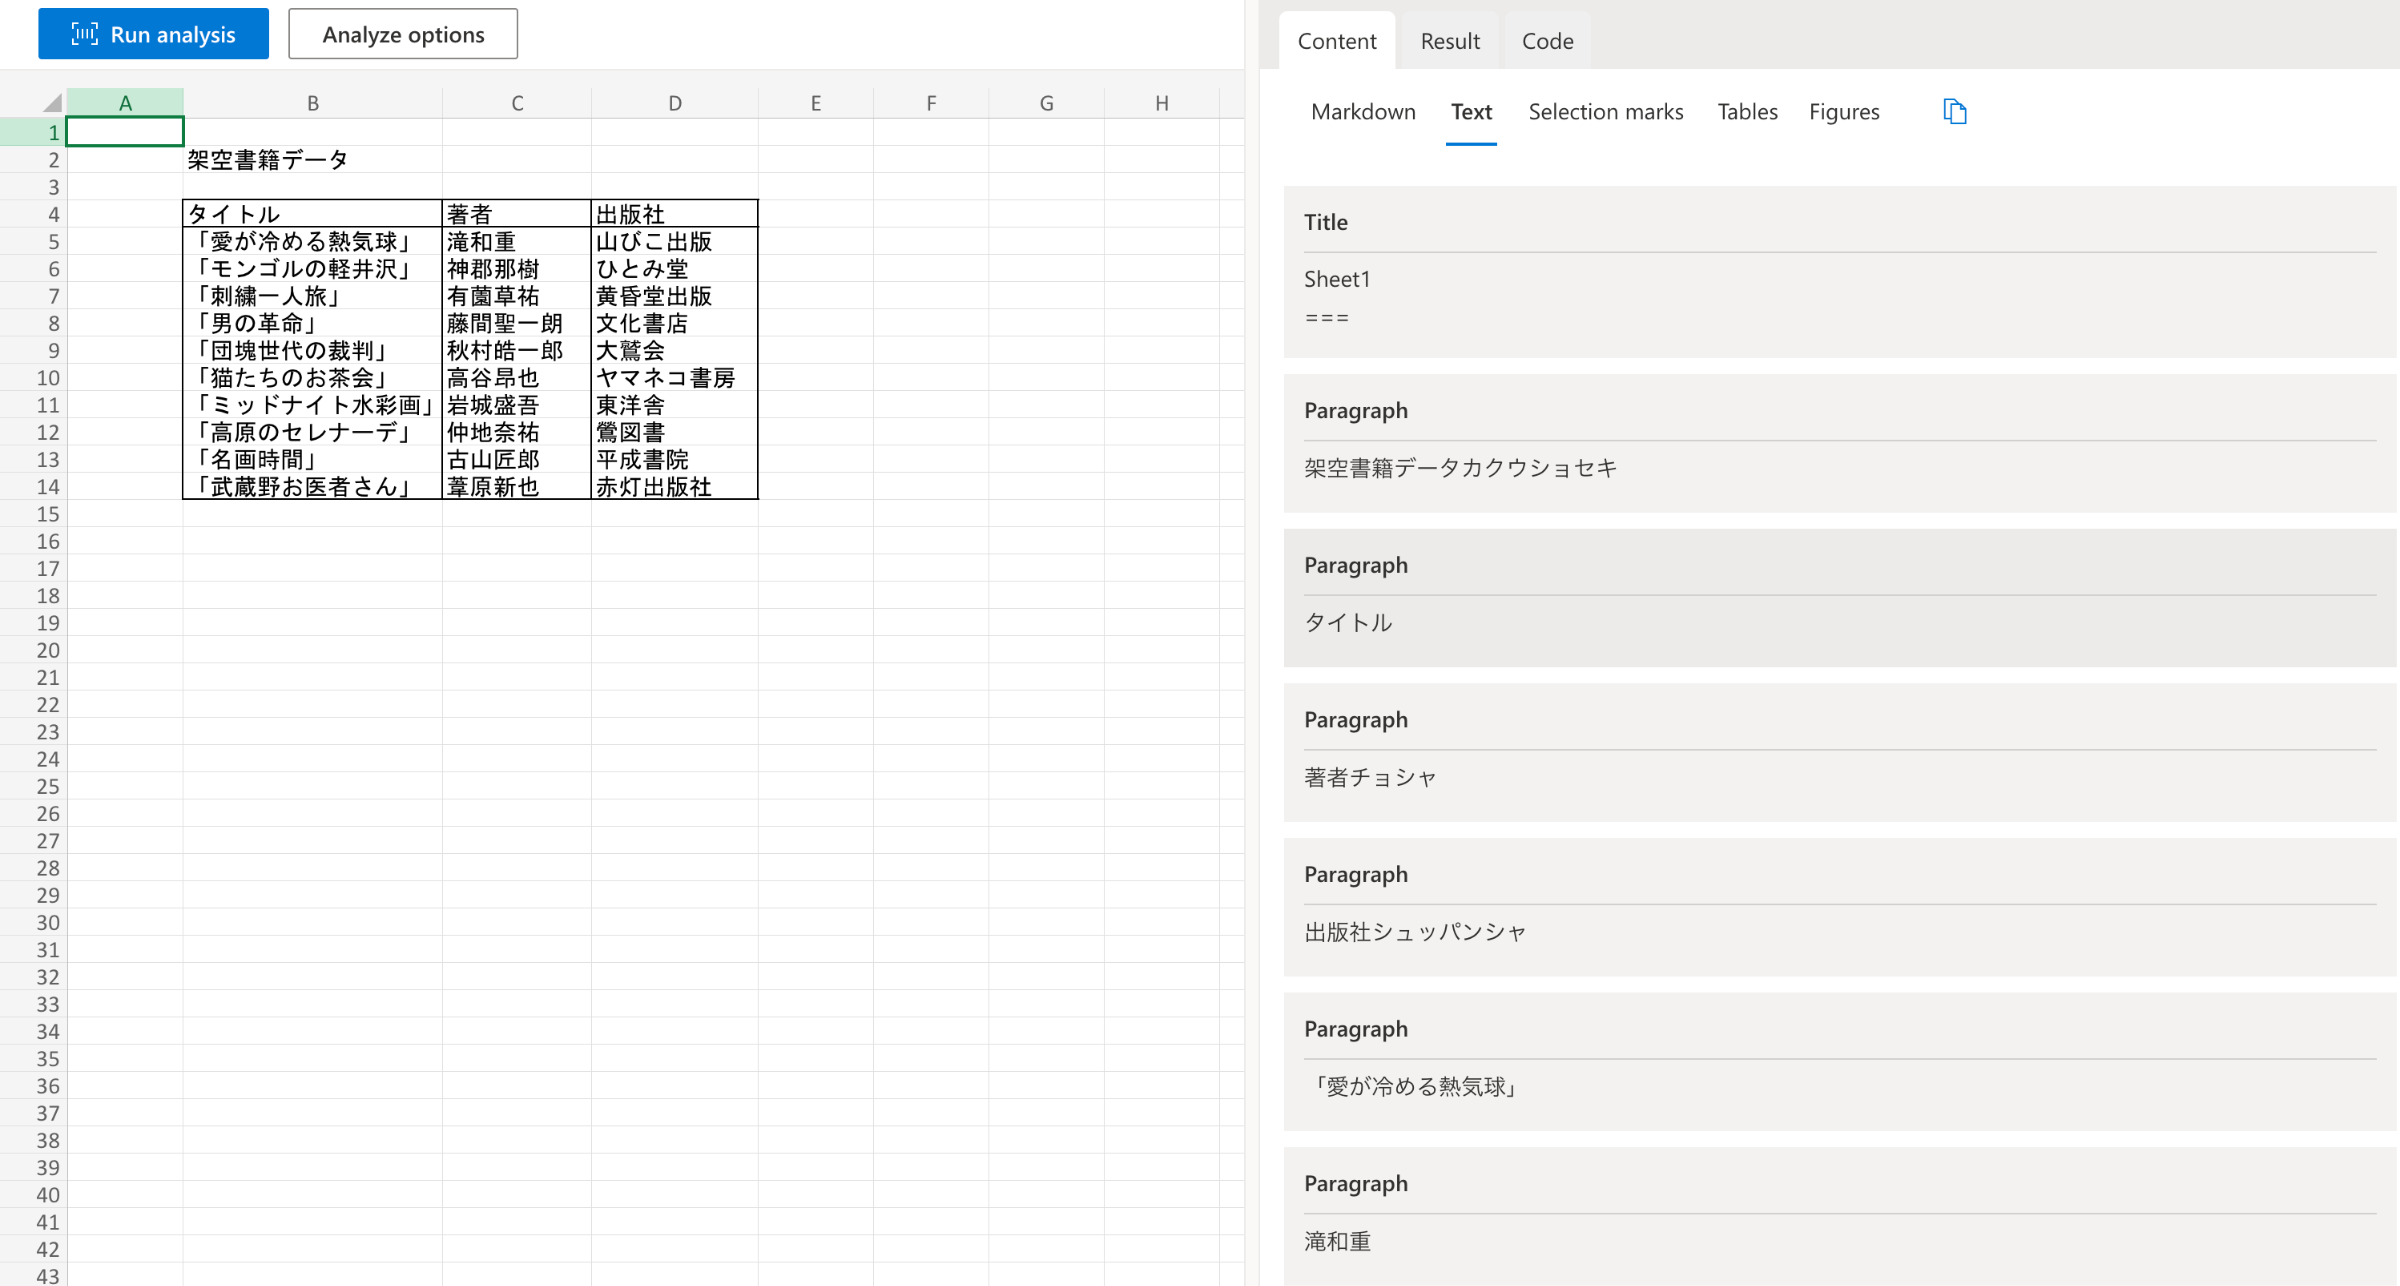
Document Intelligenceは、Excelから表形式のデータを抽出できない
これは大きな落とし穴です。 そして画像の抽出にも対応しておりません。
ExelにDocument Intelligenceは使えないですね¯\(ツ)/¯
画像ファイル
画像データもAzure Document Intelligenceで解析可能ですが、その具体的なユースケースの特定は容易ではありません。そこで、いくつかの基軸に沿って検証を進めていきます。 まず、画像の解像度や品質の変化に対する文字認識の正確性を検証します。 これは、書類が画像形式で保存されていた場合や、スキャンされた書類、さらには写真として提出された書類からのデータ抽出など、実際のビジネスシーンで頻繁に遭遇する状況に直結するため、最も重要な観点といえるでしょう。 次に、認識結果のconfidence値の分析を通じて、システムの信頼性と適用可能な範囲を評価します。
これらの観点から、Document Intelligenceの画像解析における真の価値と限界、そして潜在的な応用分野が明らかになるでしょう。
PDFのスクショ(.png) と 原本(.pdf)による解析精度の違い
Document Intelligenceにおいて、入力形式が解析精度に与える影響は無視できません。 本項では、同一文書のPDF原本(.pdf)とそのスクリーンショット(.png)を用いて比較検証を実施したいと思います。
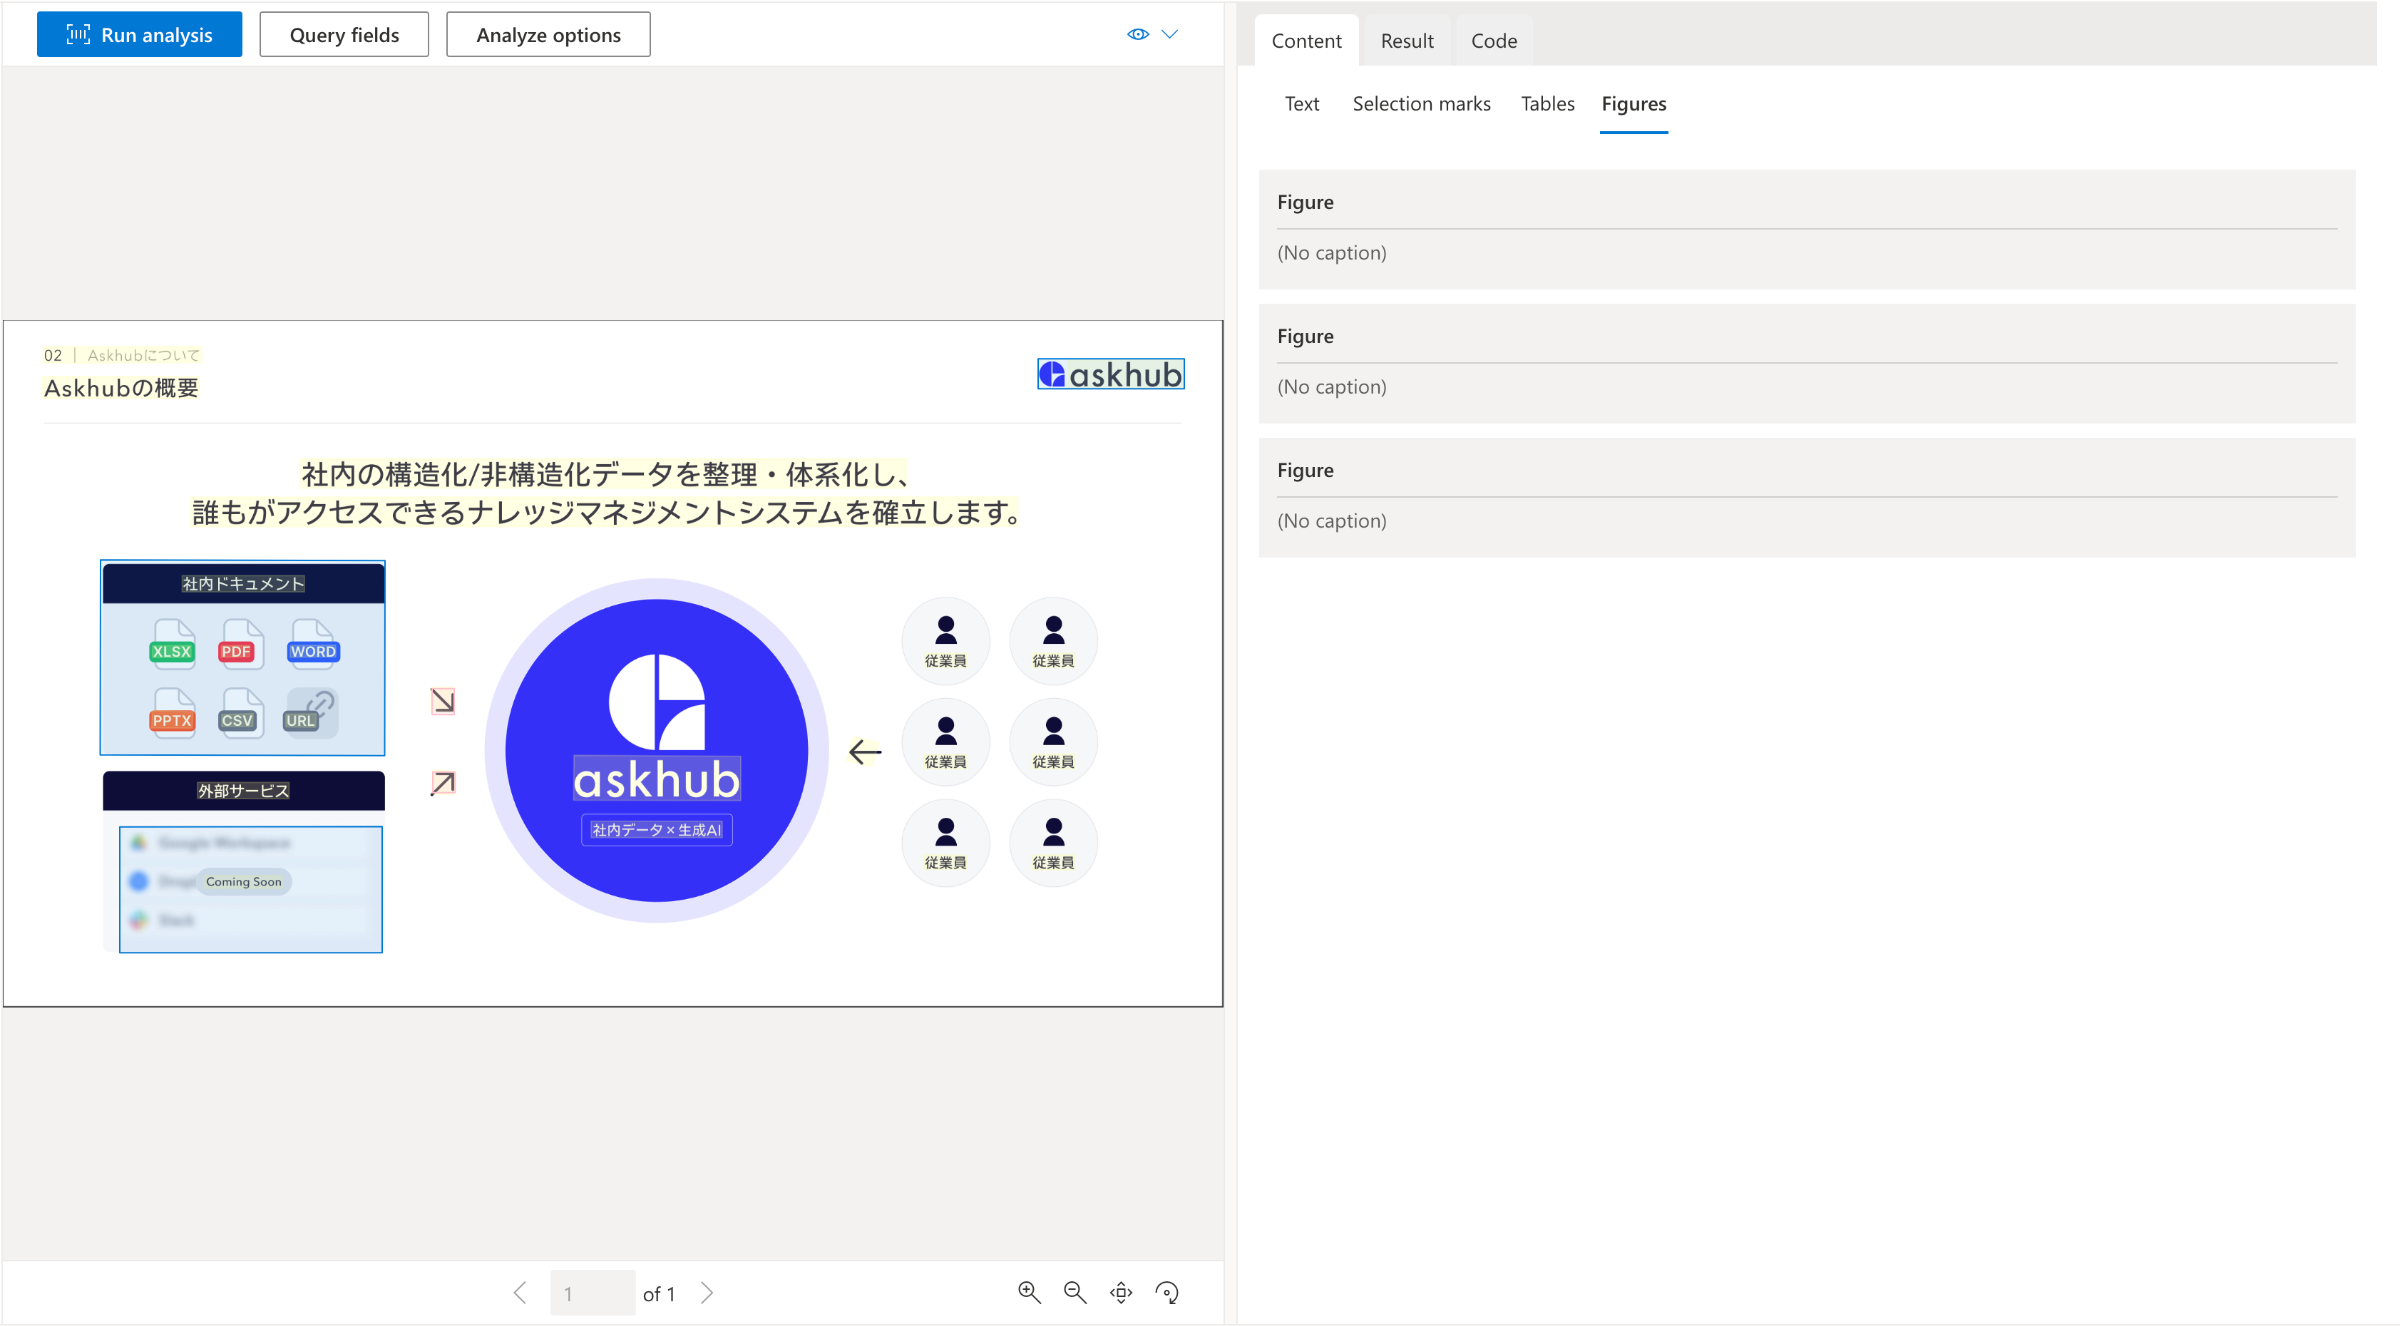
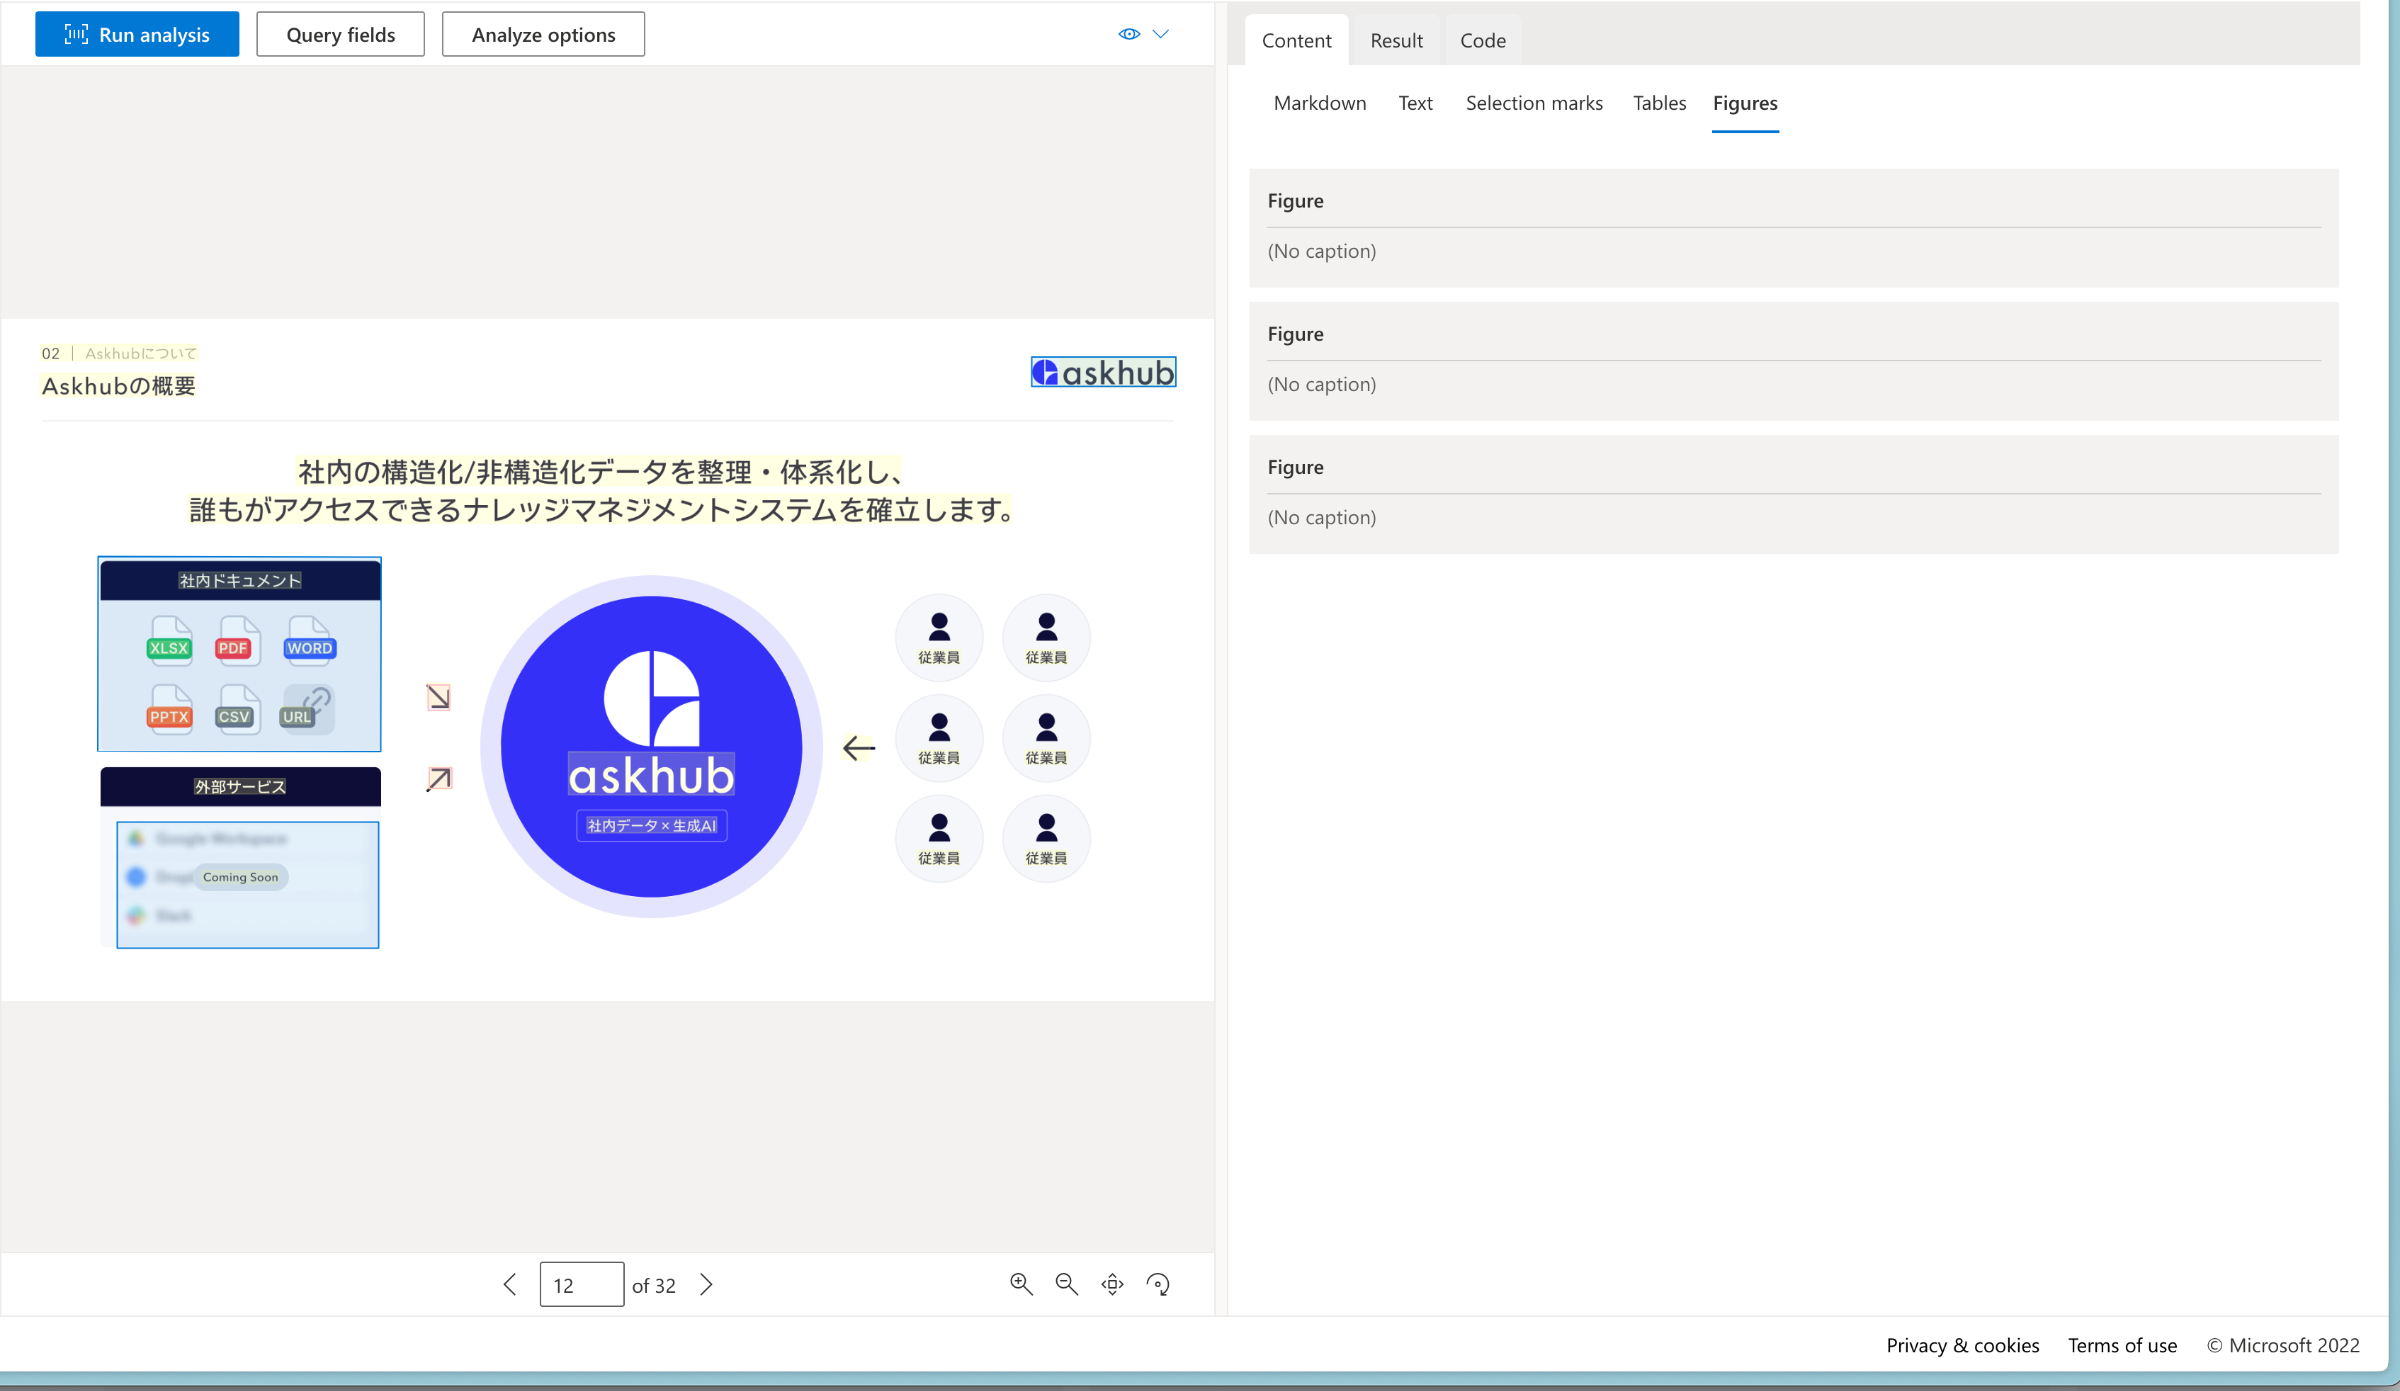
形式のみの差異の場合、同じ振る舞いをしてくれました。 テキスト、画像抽出ともに良好な挙動です。 一応iphoneのカメラで撮影した場合を試しましたが、こちらは画像抽出の精度が少し落ちてしまいました。
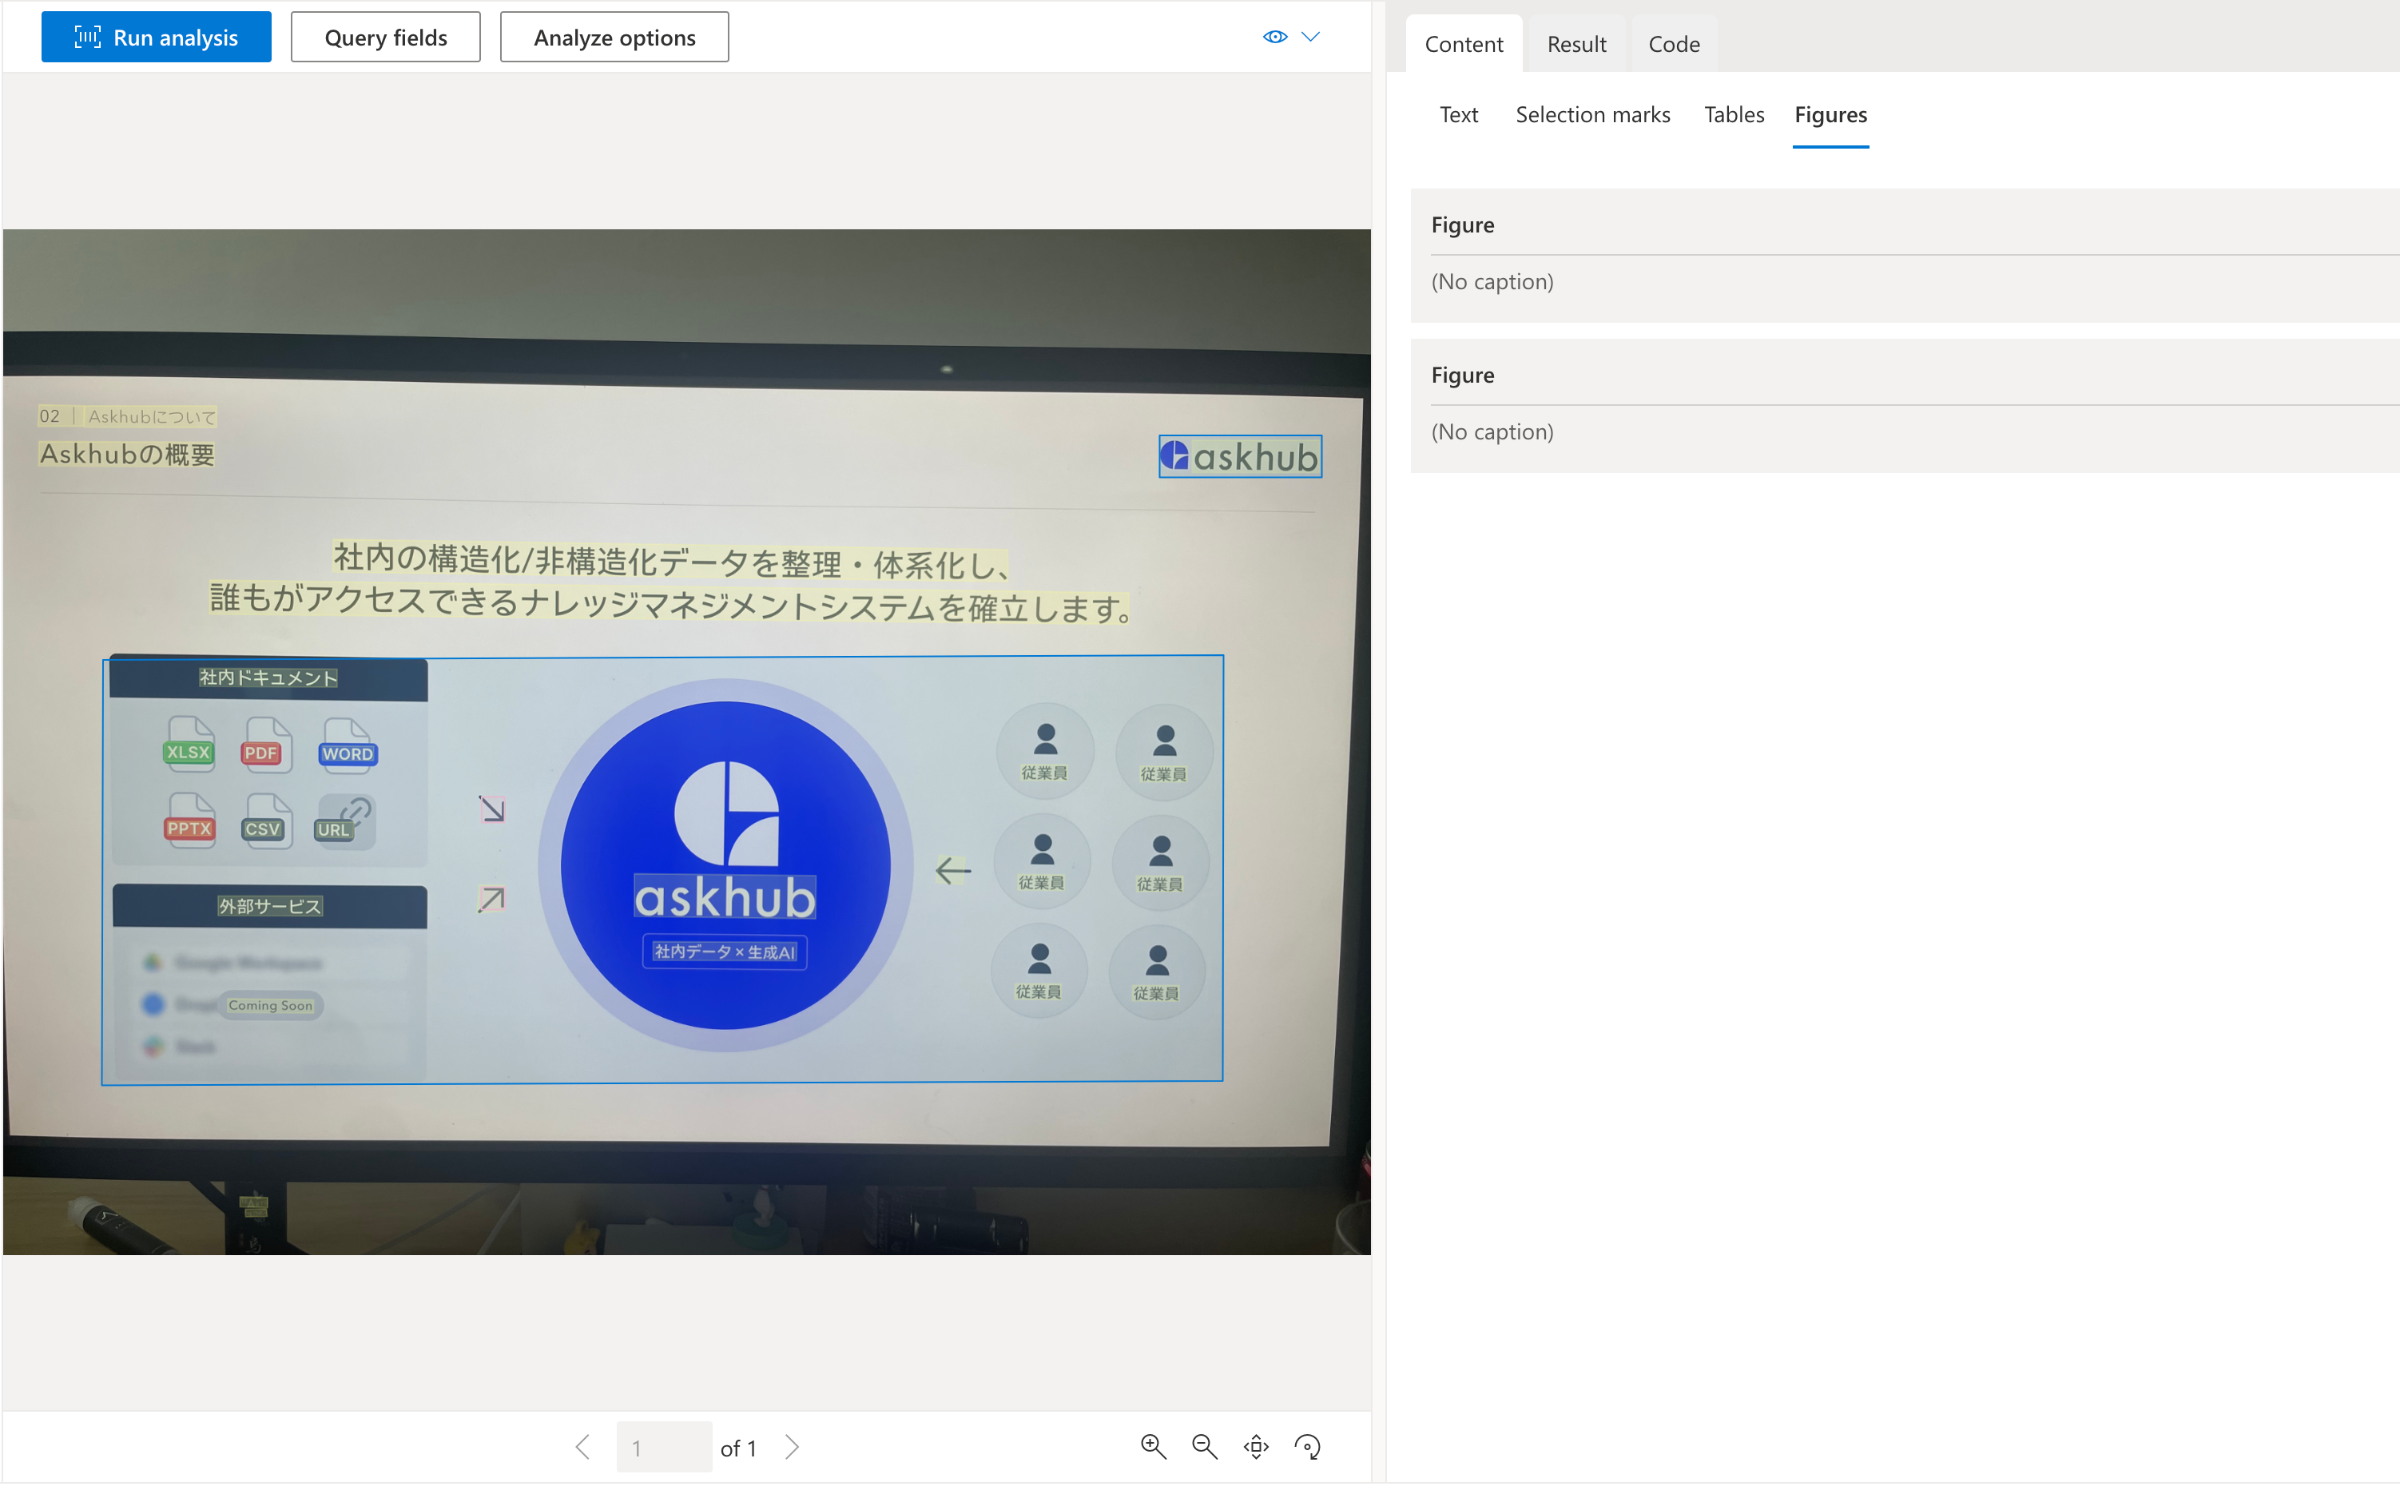
検証の結果、適切に作成されたPDFスクリーンショット(.png)と原本(.pdf)の間で、 テキスト抽出やレイアウト認識において顕著な精度差は観察されませんでした。 しかし、原本PDFから直接画像を撮影する場合、若干の精度低下が確認されました。 この結果は、文書のデジタル化および解析プロセスにおける柔軟性を示唆していると言えるでしょう。
テキスト認識精度の検証
本検証では、実際のビジネスシーンを想定し、雑に直撮りした名刺画像を用いてAzure Document Intelligenceの画像解析能力を評価します。これにより、不均一な照明、ブレ、歪み、反射などの実世界で遭遇する様々な画質の問題に対する、システムの robustness(堅牢性)を測定します。
早速レスポンスを確認しましょう。
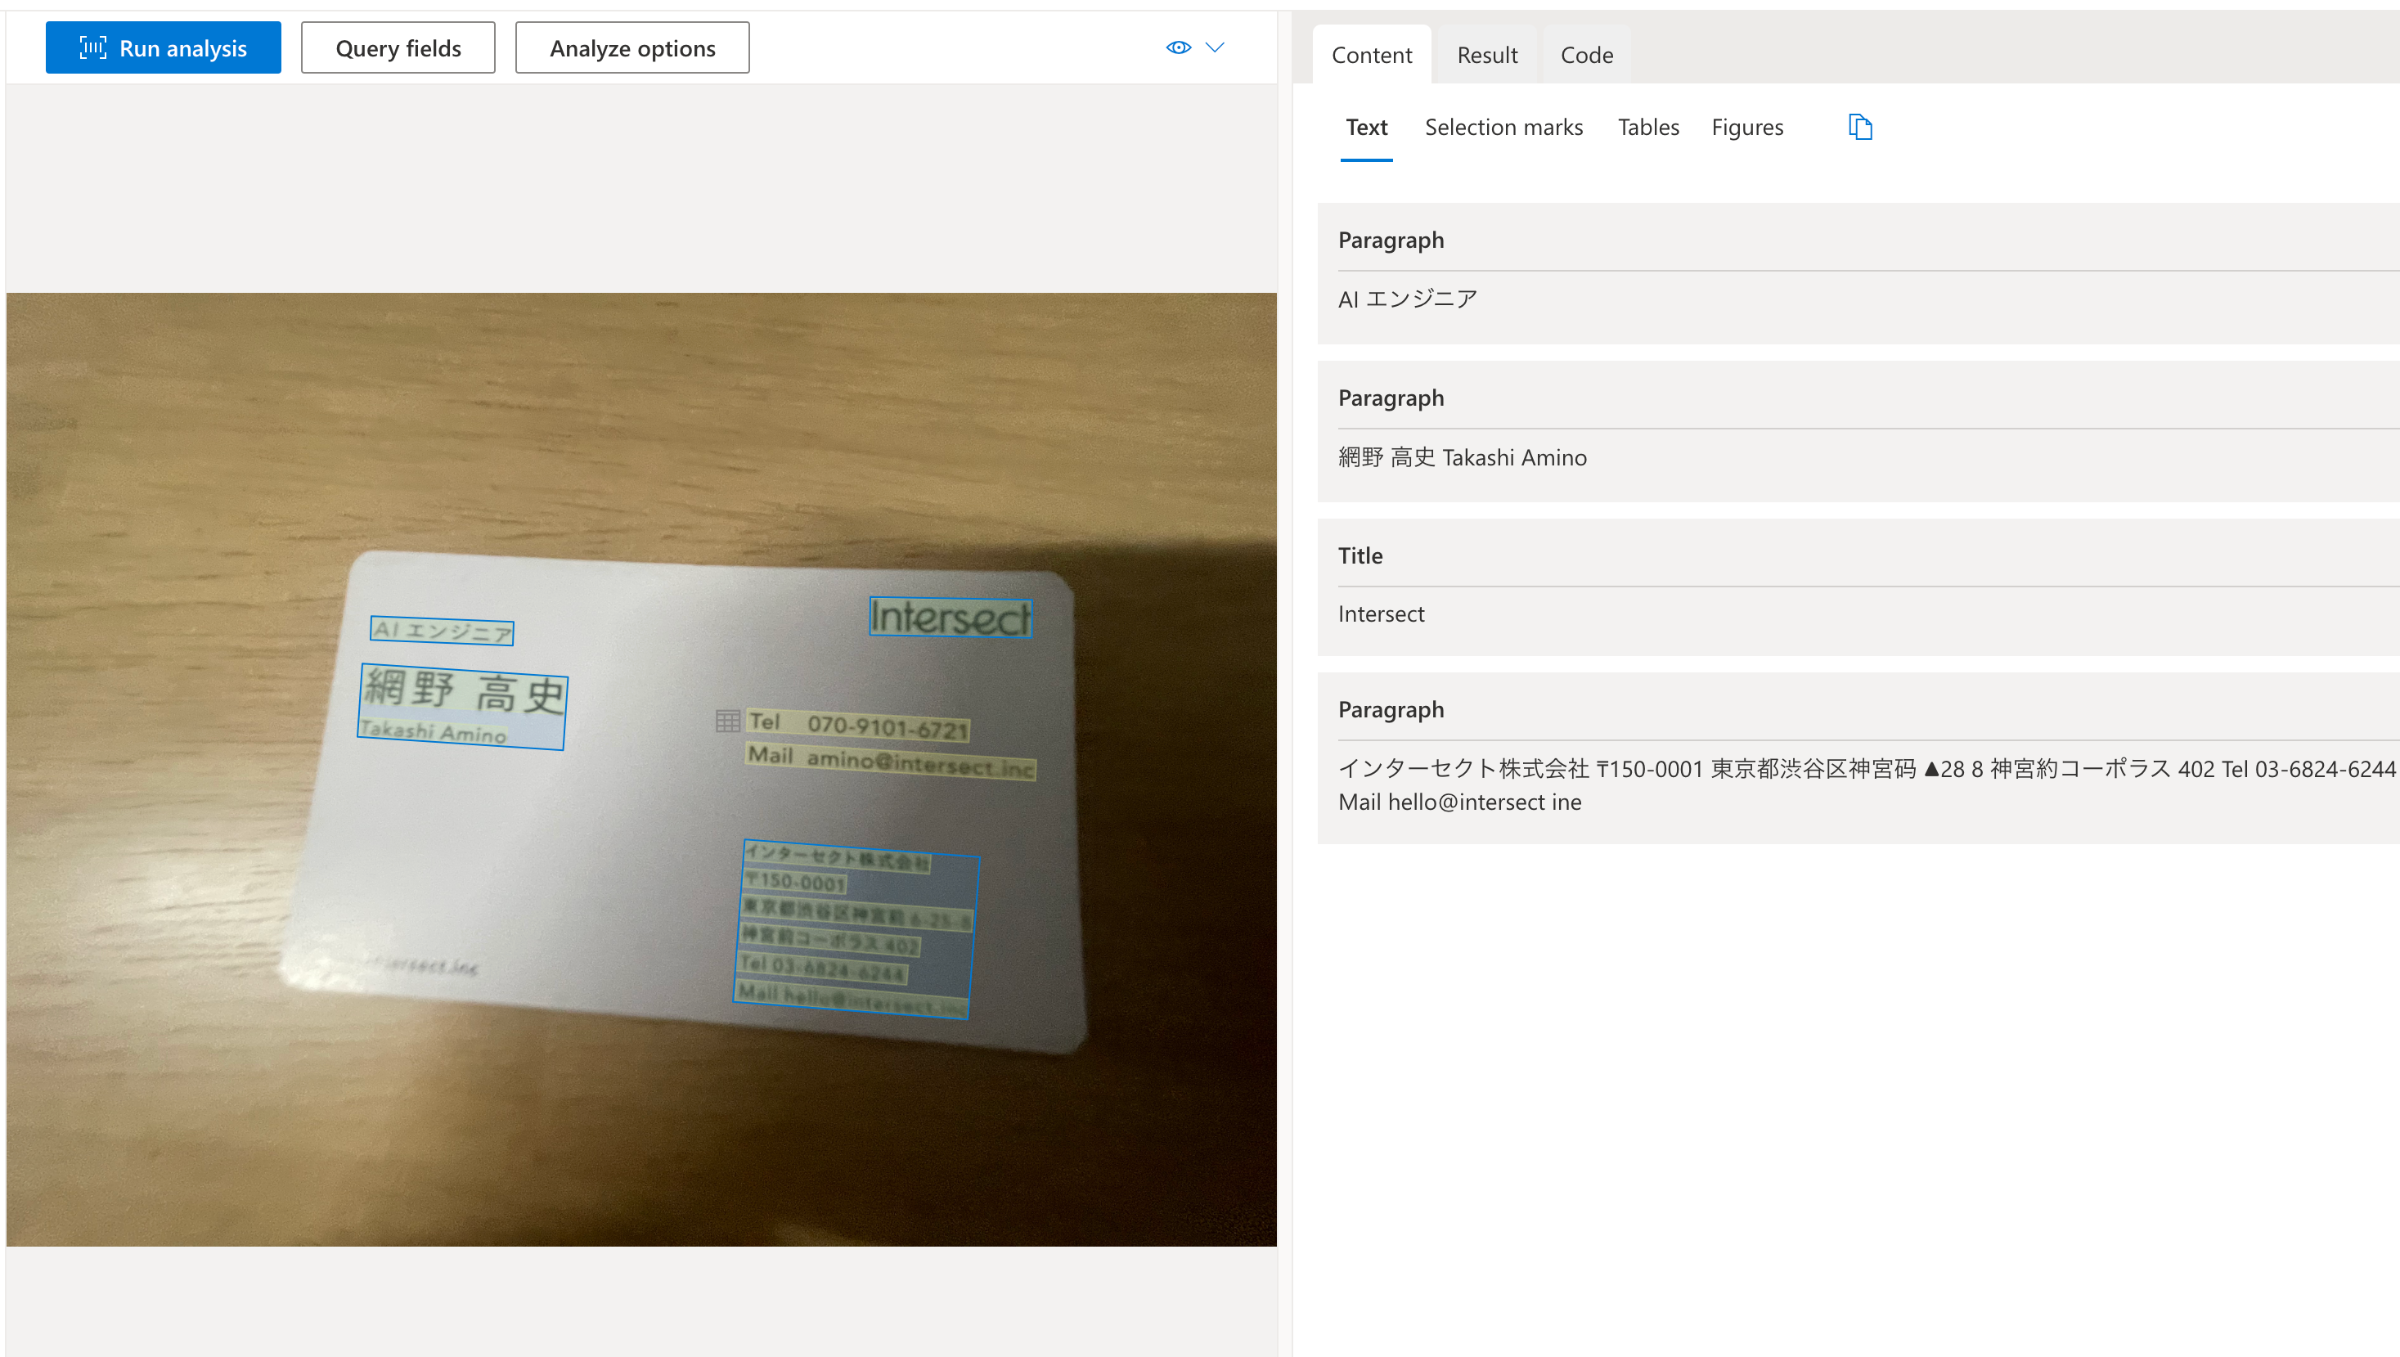
検証したところ、上記の画像程度を限界として、それ以上のものは文句なしにデータ抽出を行うことができました。素晴らしいですね。
この精度の高さは、Document Intelligenceが実際のビジネスシーンで十分に実用に耐えうる性能を持っていることを示唆しています。完璧な画質でなくとも、日常的に遭遇する様々な条件下で撮影された画像から、信頼性の高い情報抽出が可能であることが確認されました。
まとめ
検証を終えて、Azure Document Intelligenceの実力が見えてきました。率直に言って、PDFの処理能力は非常に高いです。 画像形式のドキュメント処理も、予想以上に好成績。雑に撮った名刺でさえ、そこそこ上手くこなしてくれました。ただ、PDFほどの完璧さはありません。
現状、このサービスは「Document Intelligence」として利用せず、pdf形式に変換可能なものはPDF化する。つまり「PDF Intelligence」として利用することがベストでしょう。それ以外の形式となると、まだまだ伸びしろがありそうです。
今回の記事では触れませんでしたが、カスタムレイアウトモデルなど調整範囲は広く、色々な用途に対応できそうです。活用は技術者のアイデア次第という面もあるでしょう。
技術者の皆様はスケーラビリティについても注意が必要です。デフォルトでは1秒あたり15トランザクション(15 TPS)という制限があるので、大規模な利用を考えている場合は、TPSクォータの引き上げが必須です。
さらにコストも考慮すべき点です。100ページあたり1ドルというのは、決して安くはありません。大量のドキュメントを処理する場合、コストが急激に膨らむ可能性があります。費用対効果をしっかり計算する必要がありそうです。
というわけで、Azure Document Intelligenceの可能性と限界が見えてきた今、この技術をどう活用するか、それとも他の選択肢を探すか、判断のボールは我々のコートに投げられています。さて、あなたはどうしますか?