音声AIの新標準となるか?Geminiの音声認識性能を徹底検証
はじめに
こんにちは。インターセクトの永澤です。
前回の記事ではマルチモーダル入力のうち画像入力について主要生成AIモデルの性能比較を行いましたが、今回は特に「音声入力」に着目して性能検証記事を書いていきたいと思います。
なお、2024年11月時点では主要な生成AIモデルの中でGoogleの「Gemini」が唯一音声入力可能であるため、今回はGeminiの音声認識性能について検証を行うことにしました。
弊社が運営するAskhubでもGeminiの音声入力は対応しているため、今後ユーザーの皆様が音声入力を使用する際の参考になるよう、本記事ではその性能について詳しく調査します。
Geminiについて
まず初めに、今回採用した生成AIモデルの基本スペックについて紹介します。
Googleの「Gemini」シリーズには、高性能モデルのGemini 1.5 Proと安価モデルのGemini 1.5 Flashがあります。
スペックとしてはやはり価格に大きな違いがあり、FlashはProの1/16程度のコストで利用可能です。ここまで大きな違いがあると、よほど精度に差がない限りは実用上はFlash一択になりそうです。
一方で、入力可能なトークン数や画像数などは全てProの方が2倍多くなっていますが、入力量に比例して精度が下がることを加味すると、限界まで入力する利用シーンはあまりないかなと思います。
以下ではそれぞれの基本スペックについてまとめます。
Gemini 1.5 Pro
Googleによって2024年2月に発表されたモデルで、2024年4月までのデータで学習が行われています。
入力 | 出力 | |
|---|---|---|
データ形式 | テキスト、画像、音声、動画 | テキスト |
テキスト料金 | $1.25/1M文字 | $2.50/1M文字 |
画像料金 | $0.00032875/ 枚 | - |
動画料金 | $0.00032875/ 秒 | - |
音声料金 | $0.00003125/ 秒 | - |
最大トークン数 | 2,097,152 | 8,192 |
画像の最大数 | 7,200 | - |
動画の長さの上限 | 2 時間 | - |
音声の長さの上限 | 約 19 時間 | - |
Gemini 1.5 Flash
Googleによって2024年5月に発表されたモデルで、2024年4月までのデータで学習が行われています。
入力 | 出力 | |
|---|---|---|
データ形式 | テキスト、画像、音声、動画 | テキスト |
テキスト料金 | $0.075/1M文字 | $0.30/1M文字 |
画像料金 | $0.00002 / 枚 | - |
動画料金 | $0.00002 / 秒 | - |
音声料金 | $0.000002 / 秒 | - |
最大トークン数 | 1,048,576 | 8,192 |
画像の最大数 | 3,600 | - |
動画の長さの上限 | 1 時間 | - |
音声の長さの上限 | 約 9.5 時間 | - |
Gemini Exp 1114 (おまけ)
Googleによって2024年11月に発表された試験運用版モデルです。
2024年11月20日時点で、GPT-4oを抑えChatbot Arena LLM Leaderboardで総合1位を獲得しています。
使える音声データのサイズ上限
実際に議事録作成などの業務でGeminiを利用しようとした際には、「どれくらいの長さの音声まで対応してるのか?」が気になるかと思います。ここでは、Geminiの入出力の上限から、どれくらいの長さの会議まで対応可能かを調査します。
考慮すべきポイントは3つで、
- 音声時間の上限
- ファイルサイズの上限
- 出力トークン数の上限
になります。以下でそれぞれ見ていきます。
音声時間の制限
Gemini 1.5 Proと1.5 Flashの入力可能な音声の長さはそれぞれ約19時間と約9.5時間です。
そのため、一般的な会議音声であればどちらのモデルも十分に対応可能かと思います。
ファイルサイズの制限
ファイルサイズによる上限はGemini 1.5 Proと1.5 Flash共に2GBです。そこで、ここでは2GBが実際に何時間分の音声データに対応するかを計算してみます。
音声のデータ量あたりの尺は、ビットレート(bps)によって異なります。ビットレートが高いほど、1秒あたりのデータ量が多くなるため、同じファイルサイズでも再生時間は短くなります。
あくまで目安ですが、平均的な音声の場合96kbpsから128kbpsで、高音質なものとなると192kbpsから320kbpsです。
以下では128kbpsと256bpsの場合での2GBあたりの音声時間を計算してみます。
計算方法:
- ファイルサイズをビットに変換します。 1MB = 16,000,000,000 bit (1 Byte = 8 bit)
- ビットレートで割ります。
例)
- 128 kbpsの場合: (16,000,000,000 bit) / (128,000 bps) = 約34.7時間
- 256 kbpsの場合: (16,000,000,000 bit) / (256,000 bps) = 約17.4時間
したがって、256 kbpsを超える高音質のファイルをGemini 1.5 Proに入力する場合は、入力音声長の限界である19.5時間よりも先に、ファイルサイズの限界に達してしまうことになります。
出力トークン数の制限
出力トークン数の制限は入力音声には直接関係しませんが、文字起こしを行う場合には関係してきます。
Gemini 1.5 Pro、1.5 Flash共に、最大出力トークン数は8192トークンです。ここで、日本語一文字を2トークン(ひらがな1文字1~2トークン、漢字1文字2~3トークン程度)と換算すると、4096文字出力可能になります。
したがって、文字起こしを行う場合、4096文字分の音声まで対応可能になるのですが、これは何分程度でしょうか。プロのアナウンサーは1分間に300文字読み上げるように練習するらしく、これを基準にすると13〜14分程度の音声まで文字起こし可能になります。
実際の会議ではずっと誰かが話し続けることはないかもしれませんが、参考になれば幸いです。
検証
以下では、スクリプトを複数人で読み上げた会議音声を利用して、「文字起こし」と「議事録作成」の精度検証を行っていきます。
検証①:文字起こし
<使用したデータ>
今回のテストでは、「Askhubの新機能搭載についての打ち合わせ」という議題で3名の話者で模擬打ち合わせを行い、その録音データを使用しました。
会議時間は約8分間で、録音された音声データのサイズは15MBとなっています。
音声データは以下です。
https://vimeo.com/1032280075
<検証目的>
・音声データから会話情報を正確に抜け出せるか。
・話者認識が可能か
<プロンプト>
音声データから会話の内容を書き起こしてください。
話者を識別して書き起こしてください。
話者が切り替わったら段落を変えてください。
「えー」「あのー」など文章にした際、意味を持たない言葉は省略してください。
<結果>
モデル | ①文字起こし精度 | ②話者認識精度 | ③「えー」「あのー」など不要な言葉の省略 |
Gemini 1.5 Pro | ◯:誤りはほぼない | ◯:5回全てで話者認識できた | × |
Gemini 1.5 Flash | △:内容が変わるような大きな精度の悪さはない | ×:1度も話者認識ができなかった | ◯ |
Gemini Exp 1114 | ◯:誤りはほぼない | △:5回中3回で話者認識できた | × |
Gemini 1.5 Pro:
文字起こしの精度は高く、人間でも聞き間違えるような稀なケースを除いて、誤りは見られませんでした。
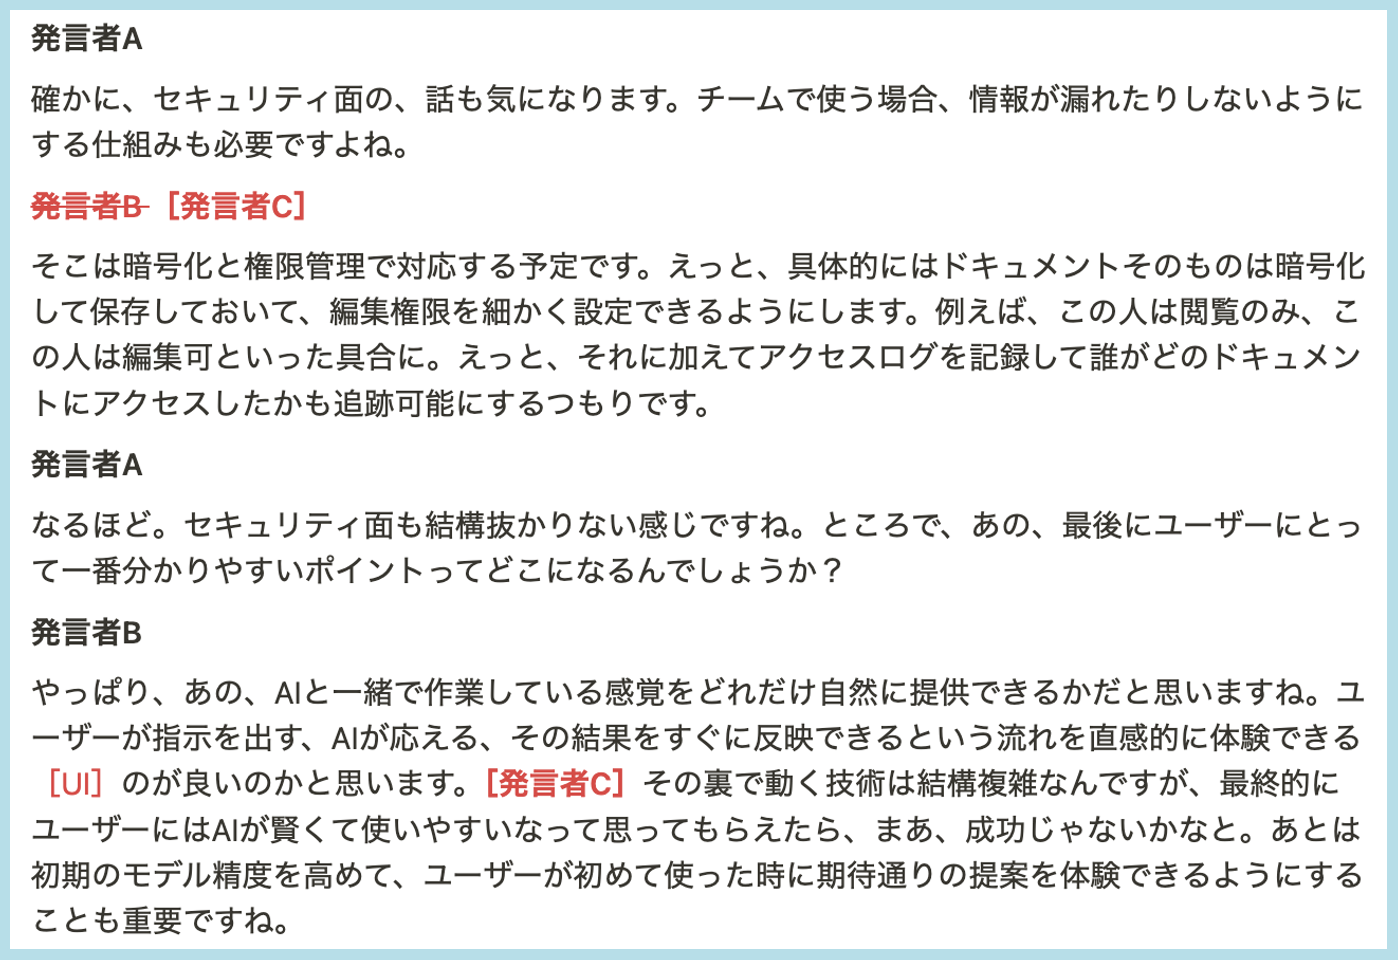
また、5回試した結果、全てのケースで話者認識を行いました。その認識制度も概ね正確で、全27回の話者の切り替わりの中で、同一話者として誤認識されたケースと、別話者として誤認識されたケースがそれぞれ1件のみでした。
一方で、「えー」「あのー」といった不要語を省略する指示をプロンプトに記述したにも関わらず、こちらは正しく実行されませんでした。
Gemini 1.5 Flash:
文字起こしの精度は高く、内容が大きく変わるほどの誤りは見られませんでしたが、「クリック」や「フロントエンドサイド」といった横文字の単語では、Gemini 1.5 Proよりはやや高頻度で誤認識が発生していました。
また、プロンプトの内容を少しずつ変えて5回ほど試したものの、話者認識は一切機能しませんでした。
一方で、特筆すべき点として、「えー」「あのー」といった不要語の省略が全モデルの中で唯一正確に実行されました。
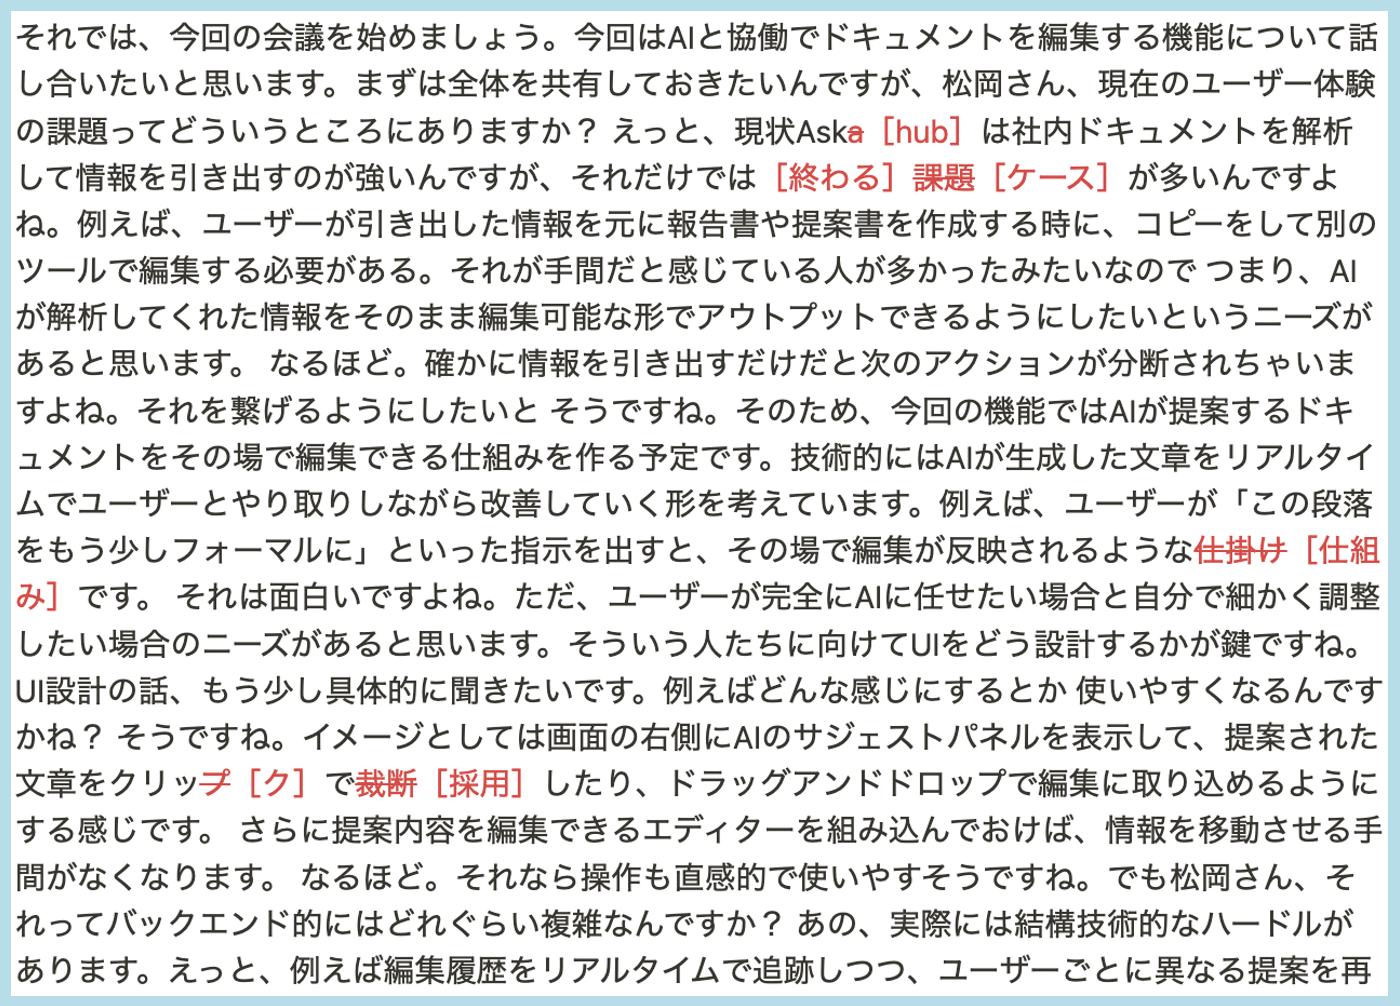
Gemini Exp 1114:
文字起こしの精度は高く、人間でも聞き間違えるような稀なケースを除いて、誤りは見られませんでした。
しかし、話者認識制度はあまり良くなく、5回試行したうち2回は話者認識が行われませんでした。
またProと同様に、今回プロンプトで指示した段落切り替えが無視され、文章には「えー」「あのー」といった不要語も含まれていました。
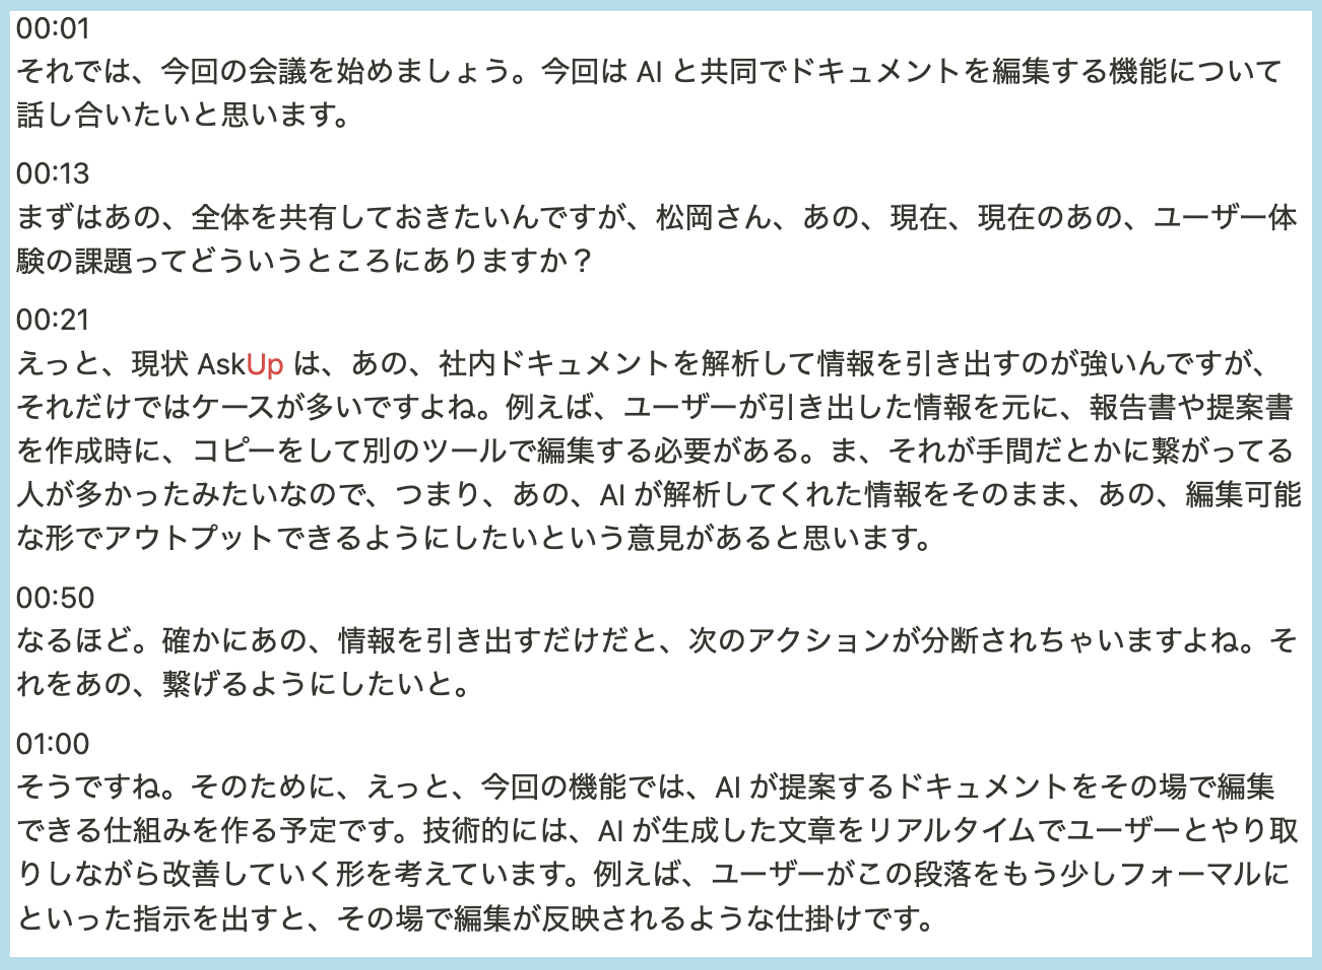
まとめ:
精度はGeminiモデル全体で高水準でしたが「話者認識」と「不用語の除去」ではモデルによる違いが見られました。
話者認識について、今回のプロンプトではGemini 1.5 Flashでは一度も成功しませんでしたが、「話者を識別して書き起こしてください。」のようなシンプルなプロンプトの場合、Flashでも話者を識別して、文字を書き起こしてくれました。今回はプロンプトにて「書き起こし」「話者識別」「段落変更」「不要語の削除」と4つの行動をAIに指示しましたが、音声データのインプットと同時に複数の指示を行った場合、Flashの推論能力では全てに対応できなったのかなと思います。そのため、Flashで文字の書き起こしをする際にはできるだけシンプルなプロンプトを用いることを推奨します。
一方で、不用語の除去についてはFlashのみが成功するという意外な結果になりました。一般に生成AIはプロンプトの最初と最後の文章の影響を強く受けますが、その特徴がFlashで顕著に出たのかもしれません。
検証②:議事録作成
<使用したデータ>
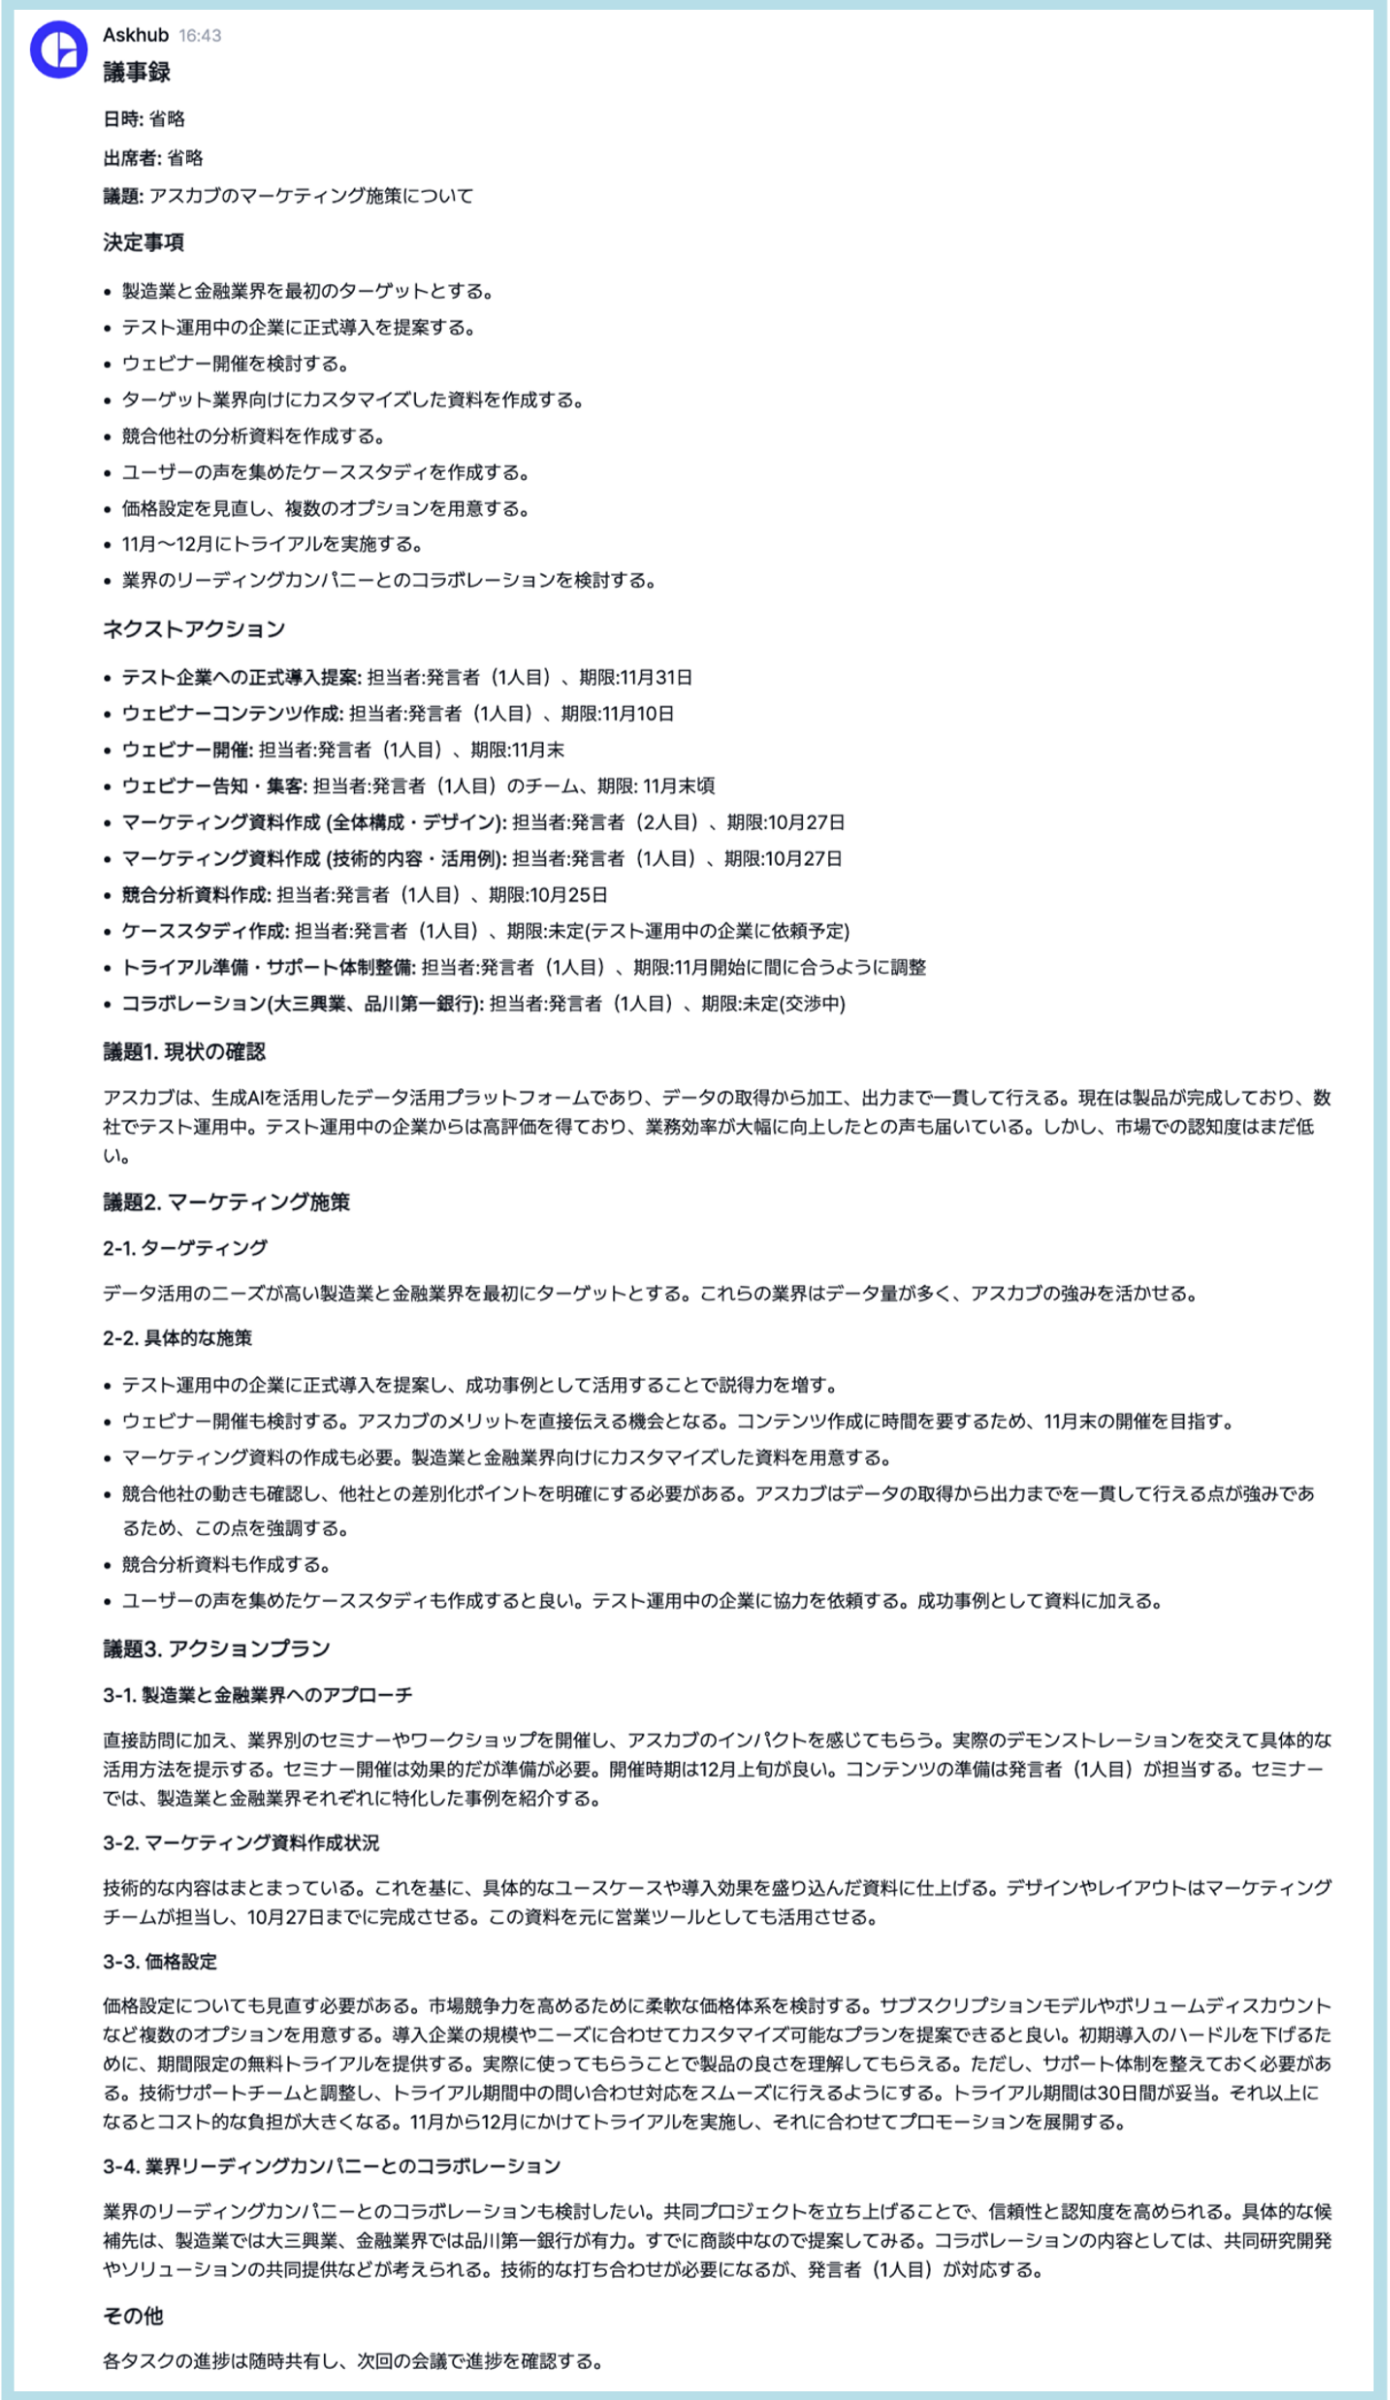
今回のテストでは、「Askhubのマーケティング施策について」という議題で、3名の話者で模擬で打ち合わせを実施し、その録音データを使用しました。
あまりGemniに意地悪しても可哀想なので、決定事項やネクストアクションなどを会議中に明言しているスクリプトを用いて音声を作成しました。
会議時間は約6分間で、録音された音声データのサイズは3MBとなっています。
音声データは以下です。
https://vimeo.com/1032283217
<プロンプト>
音声データから以下の形式で議事録を作成してください。
-会議での主要な「決定事項」を冒頭でまとめてください。
-次に、「ネクストアクション」をまとめてください。担当者や期日の情報が合わせて記述してください。
-その後、各議題の見出しを設け、議題ごとに要点を記述してください。
-見出しや箇条書きを活用し、読みやすい構造で記述してください。
<期待される回答>
会話内容から以下内容を正しく抽出できている
①アジェンダ(議題)
②討論内容・決定事項
③ネクストアクション
<結果>
Gemini 1.5 Pro:
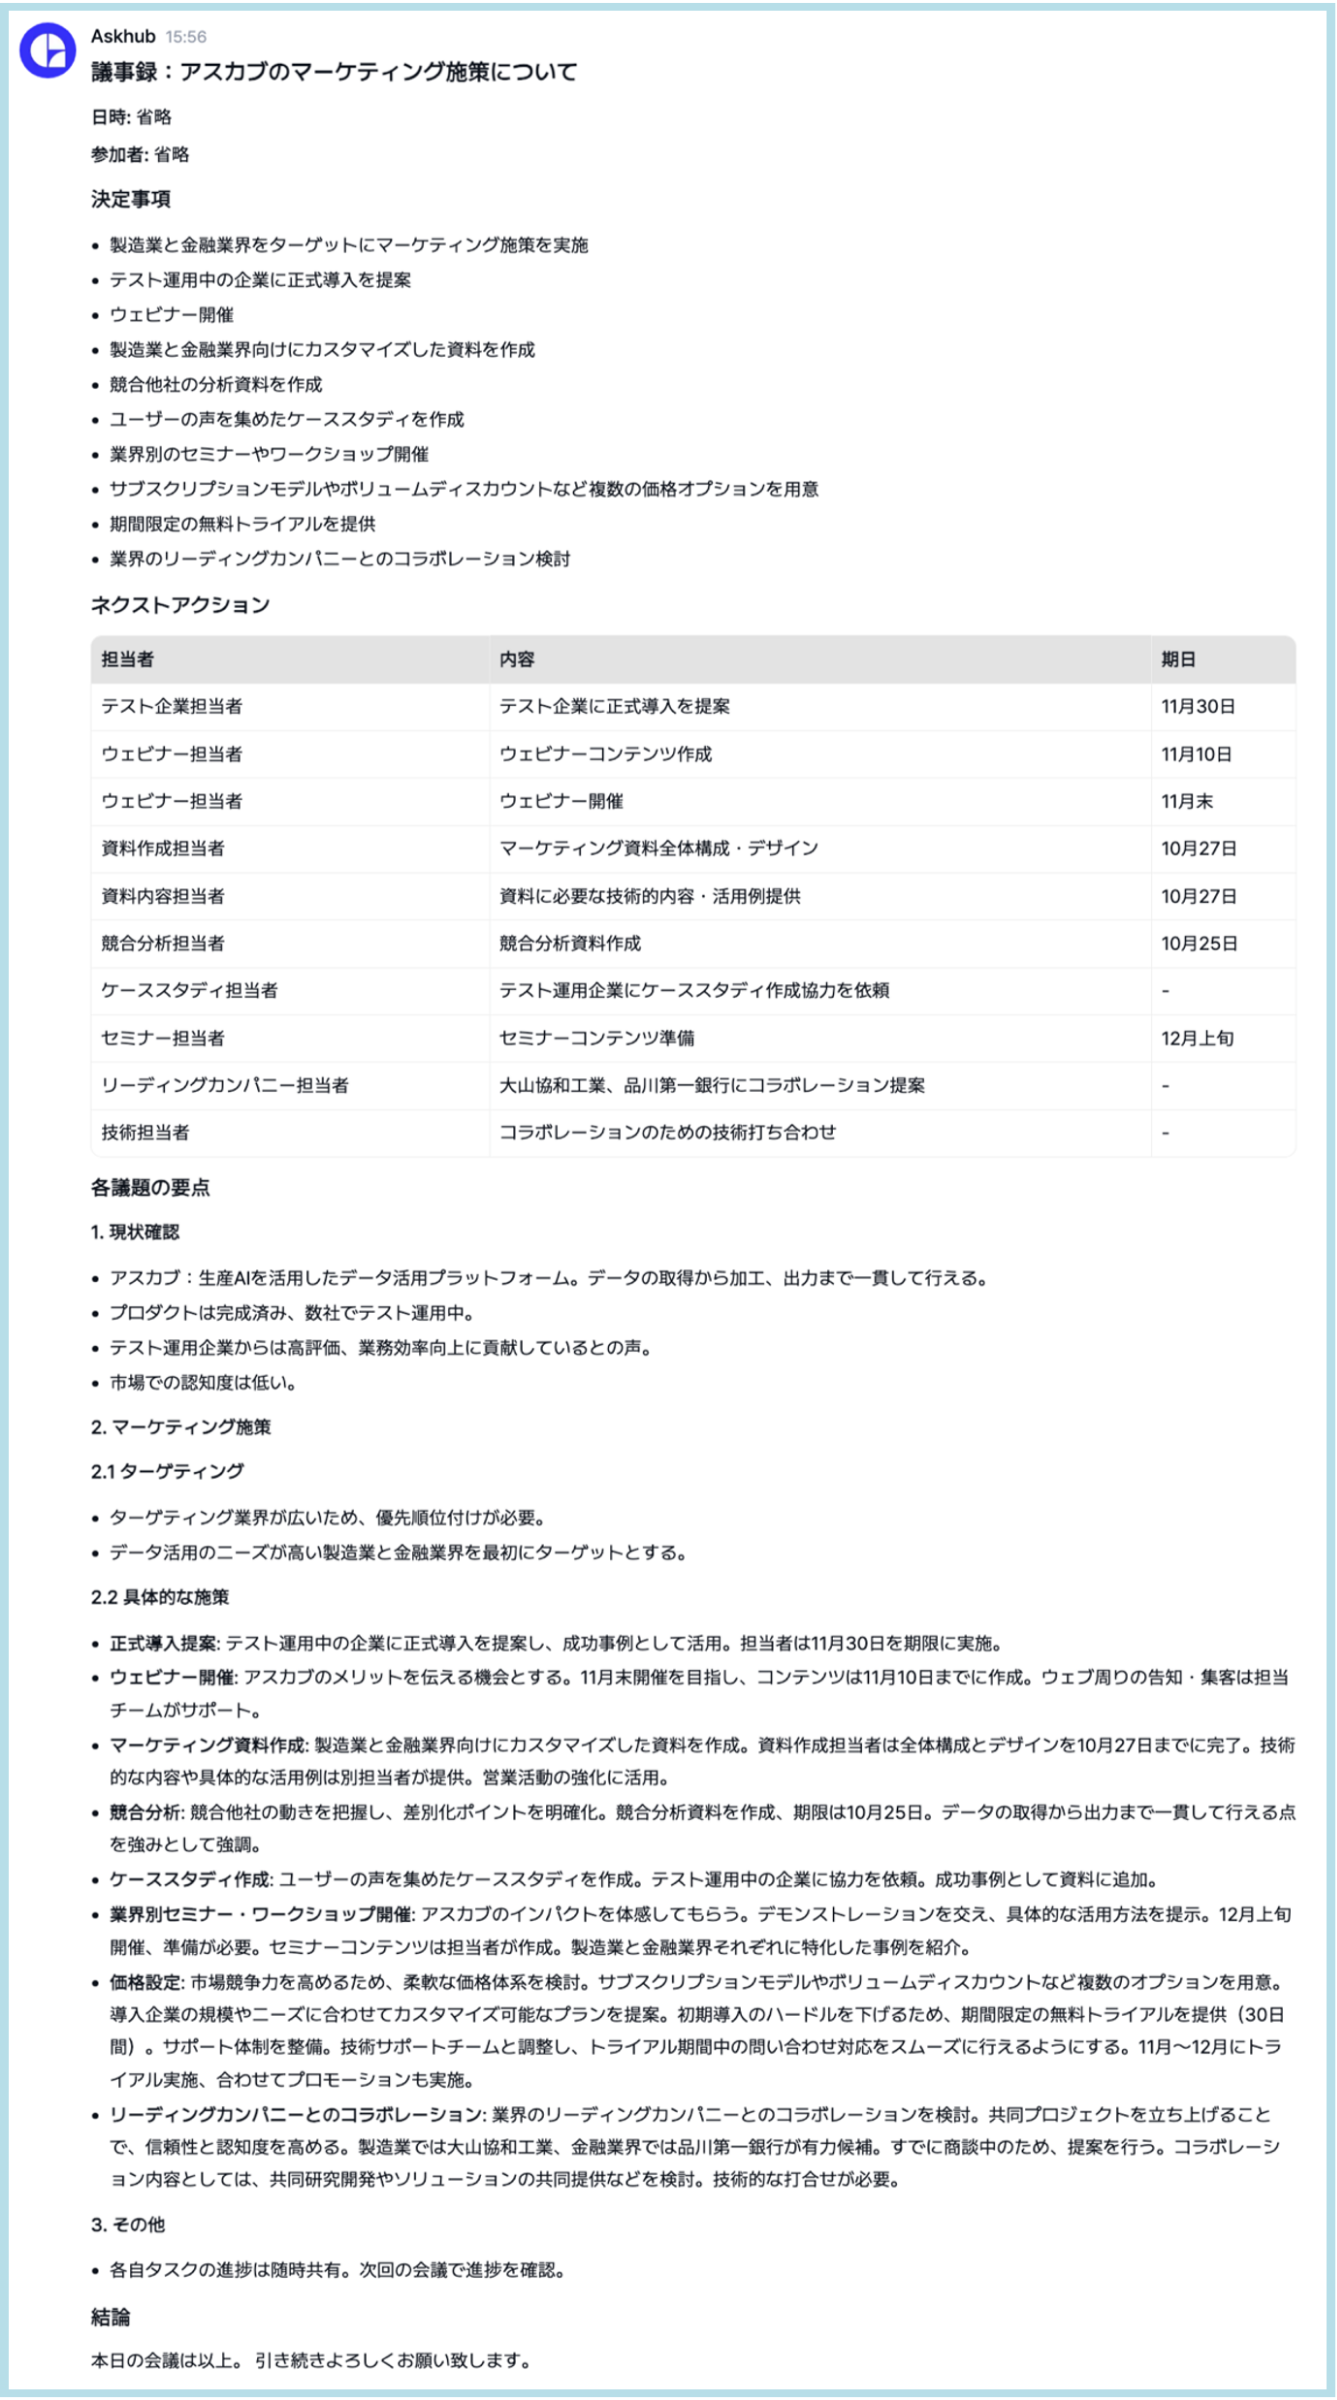
議事録作成において高い精度を発揮し、必要な事項をすべて正確に抽出しました。プロンプトの指示に従い、読みやすい文章構成が意識されており、「ネクストアクション」は表形式で整理されていました。
正直人間の書いた議事録よりも良いレベルで、文句のつけようがないです。
Gemini 1.5 Flash:
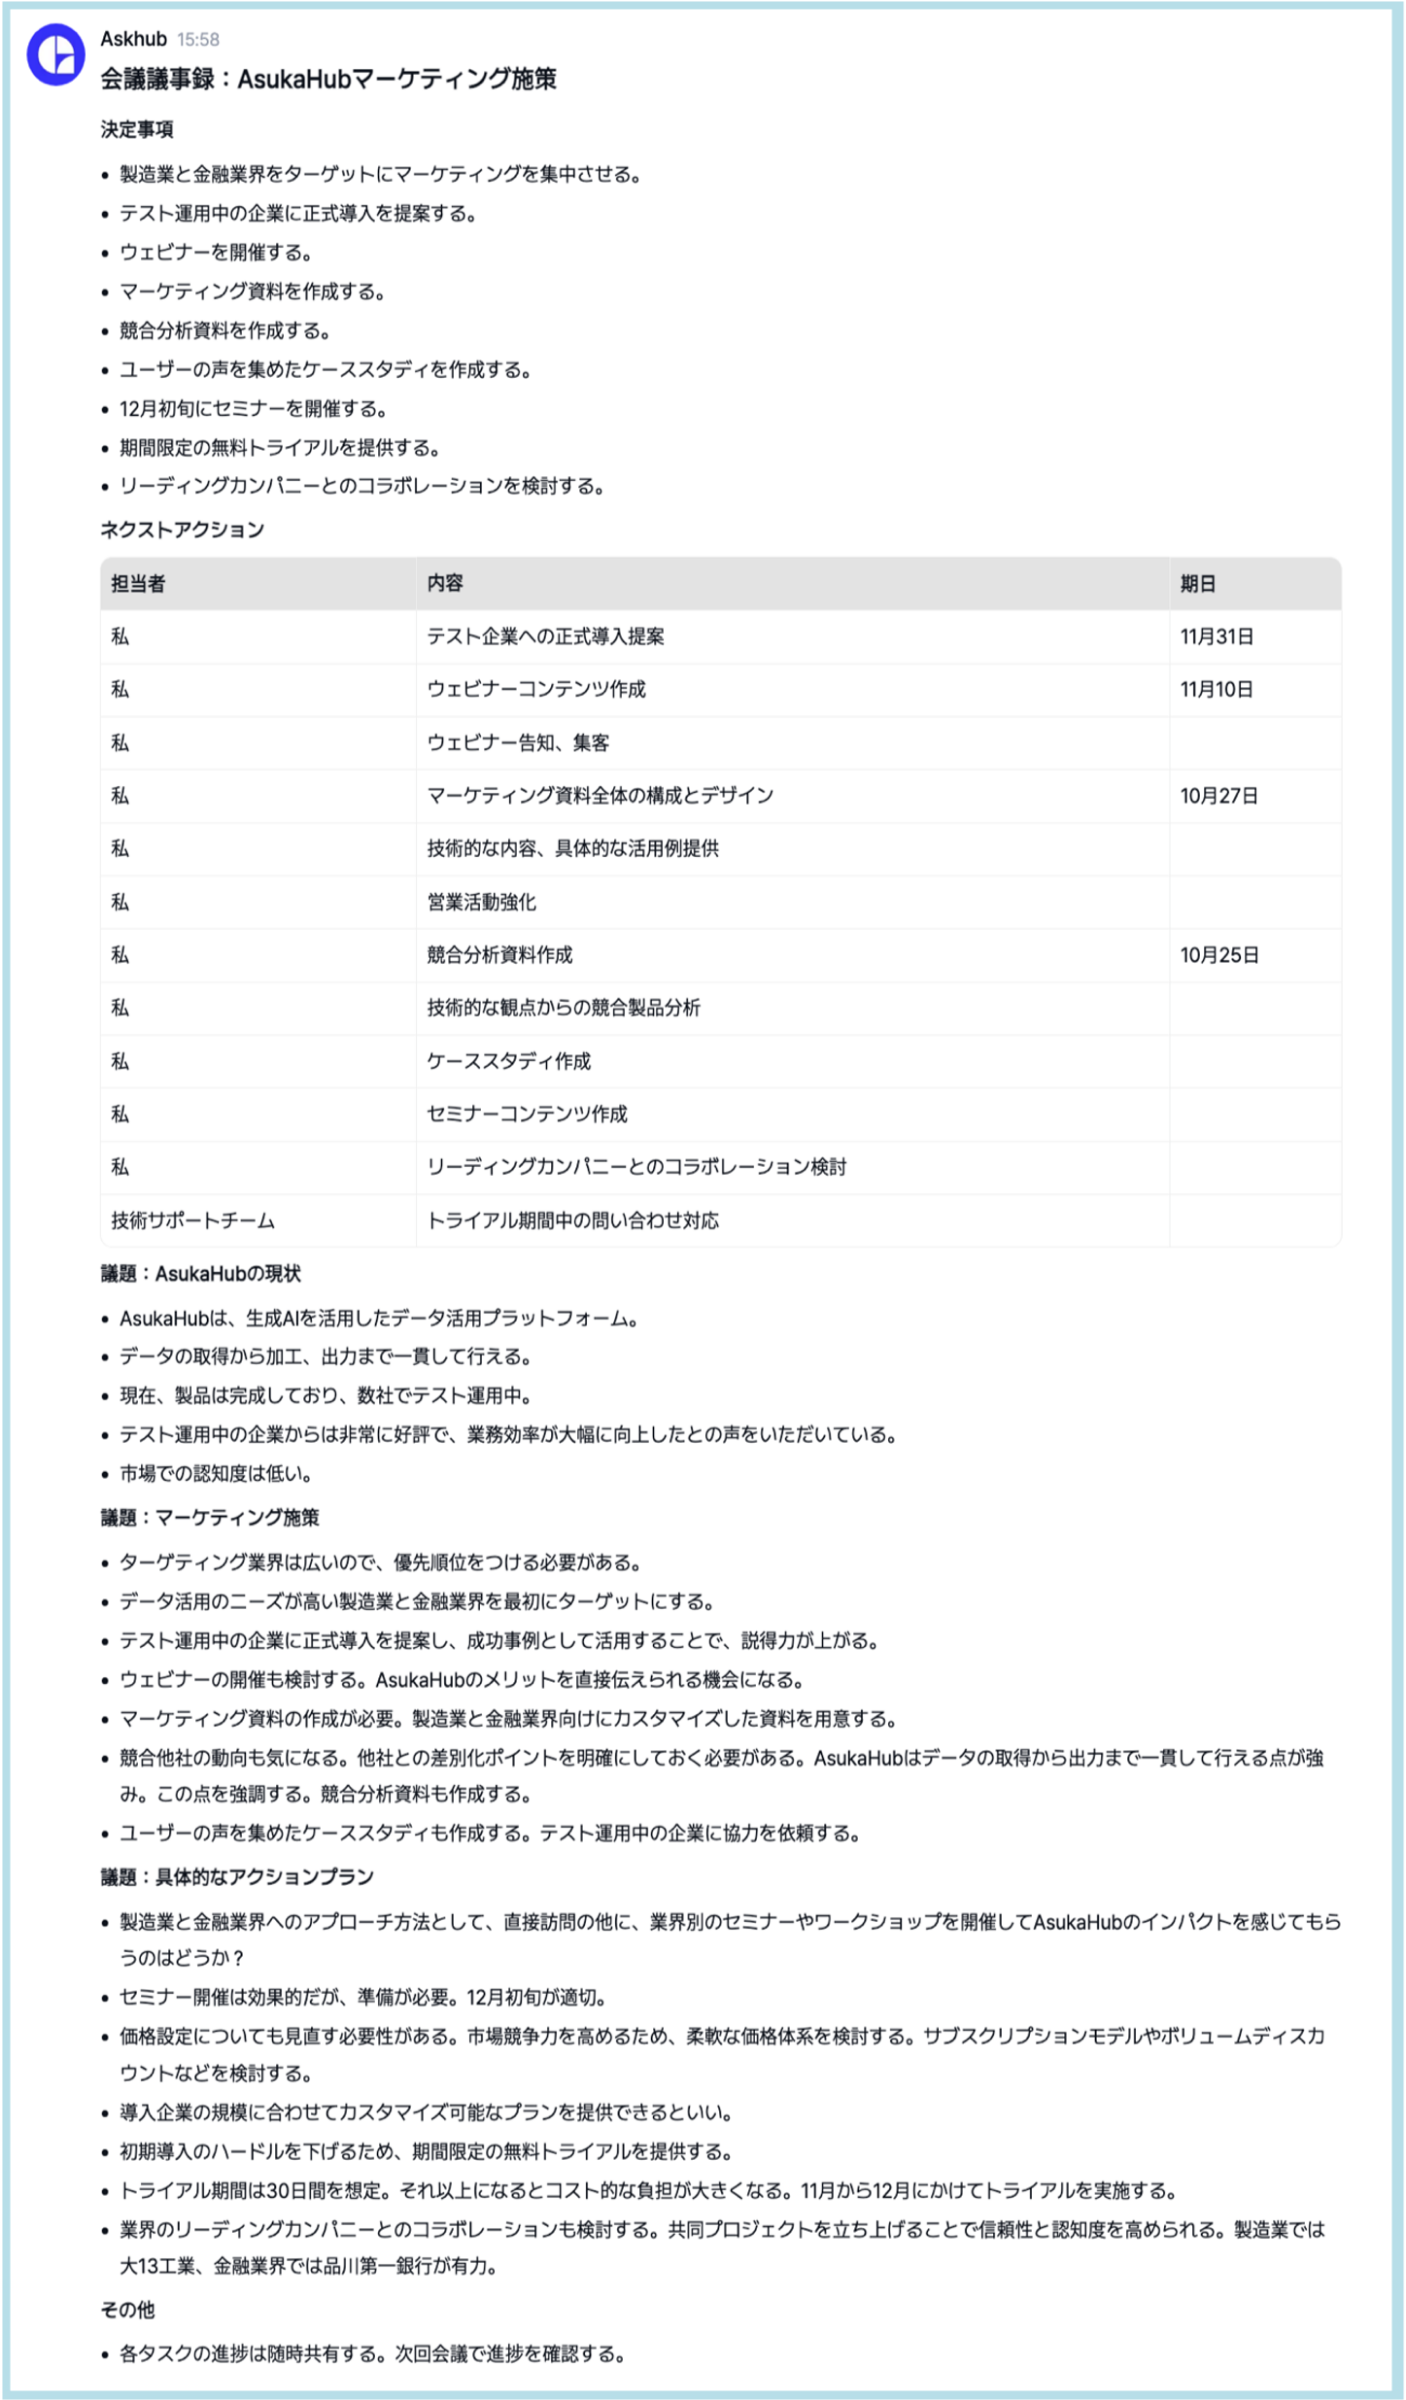
議事録作成において必要事項をある程度正確に抽出することができました。
しかし、表中では、
- 担当者をほとんど全て私にしてしまう
- セミナーコンテンツ準備の期日(12月上旬)の記載が漏れる
など、誤りも散見され、推論能力の低さが垣間見れました。
それでも価格が1/16であることを考えると十分実用的ではありますが、、。
Gemini Exp 1114:
議事録作成において高い精度を発揮し、必要な事項をすべて正確に抽出しました。
今回Gemini Exp 1114は上記2つのモデルと異なり表形式は用いていませんでしたが、それでも十分読みやすい構造とスタイルになっていました。会話内容を適切に要約し、より詳細に各マーケティング施策の情報を記載していました。
まとめ:
議事録の作成に関しては、Gemini 1.5 ProとGemini Exp 1114が必要事項を全て抽出できてており、かつかなり見やすく内容をまとめられていました。
しかし、Gemini 1.5 Flashも会議全体の要約として使う分には十分なレベルであるため、社内会議と社外会議で使い分けるなど、シーンによって使い分けると良いと感じました。
最後に
ご覧いただきありがとうございました。今回はGeminiを用いた音声認識性能の評価を行いましたが、すべてのGeminiモデルが高い精度で音声を認識できることに驚きました。
1、2年前に会議で文字起こしツールを使用した際には全く実用的ではなかった記憶がありますが、今回の結果から人による修正がなくても、Gemini単体で議事録作成が十分に行えると感じました。
また、Geminiは話者認識だけでなく、音声から話者の感情や人物像を特定することが可能な話者分析も行えるため、今後はその検証も進めていきたいと考えています。
社内データを連携した生成AI活用なら「Askhub」
インターセクトは、独自の情報探索AIを搭載した「Askhub」を提供しています。
Askhubは、社内のデータ活用プラットフォームとして、生成AIによるデータの取得→加工→出力までを一貫して行える環境を構築します。これにより従来の生成AIによる情報取得から一歩進んだ”高度なデータ活用”を実現します。
AWSの国内リージョンにも対応しており、安全な環境下で最新の生成AIモデルをご利用いただけます。さらに、個社ごとに管理しているクラウド環境へのデプロイプランもご用しており、セキュリティポリシーへの柔軟な対応が可能です。
Askhubを運用することで、セキュリティレベルを維持したまま、業務データを連携した生成AIの活用を可能にします。
詳細は下記リンクをご覧ください。