AIに人を残すべきか ― 論文で読むHITL
はじめに
AIを業務に取り入れたい。けれど、完全自動ですべてを丸ごと任せるのは怖いと、多くの企業が、この迷いの前で立ち止まっています。
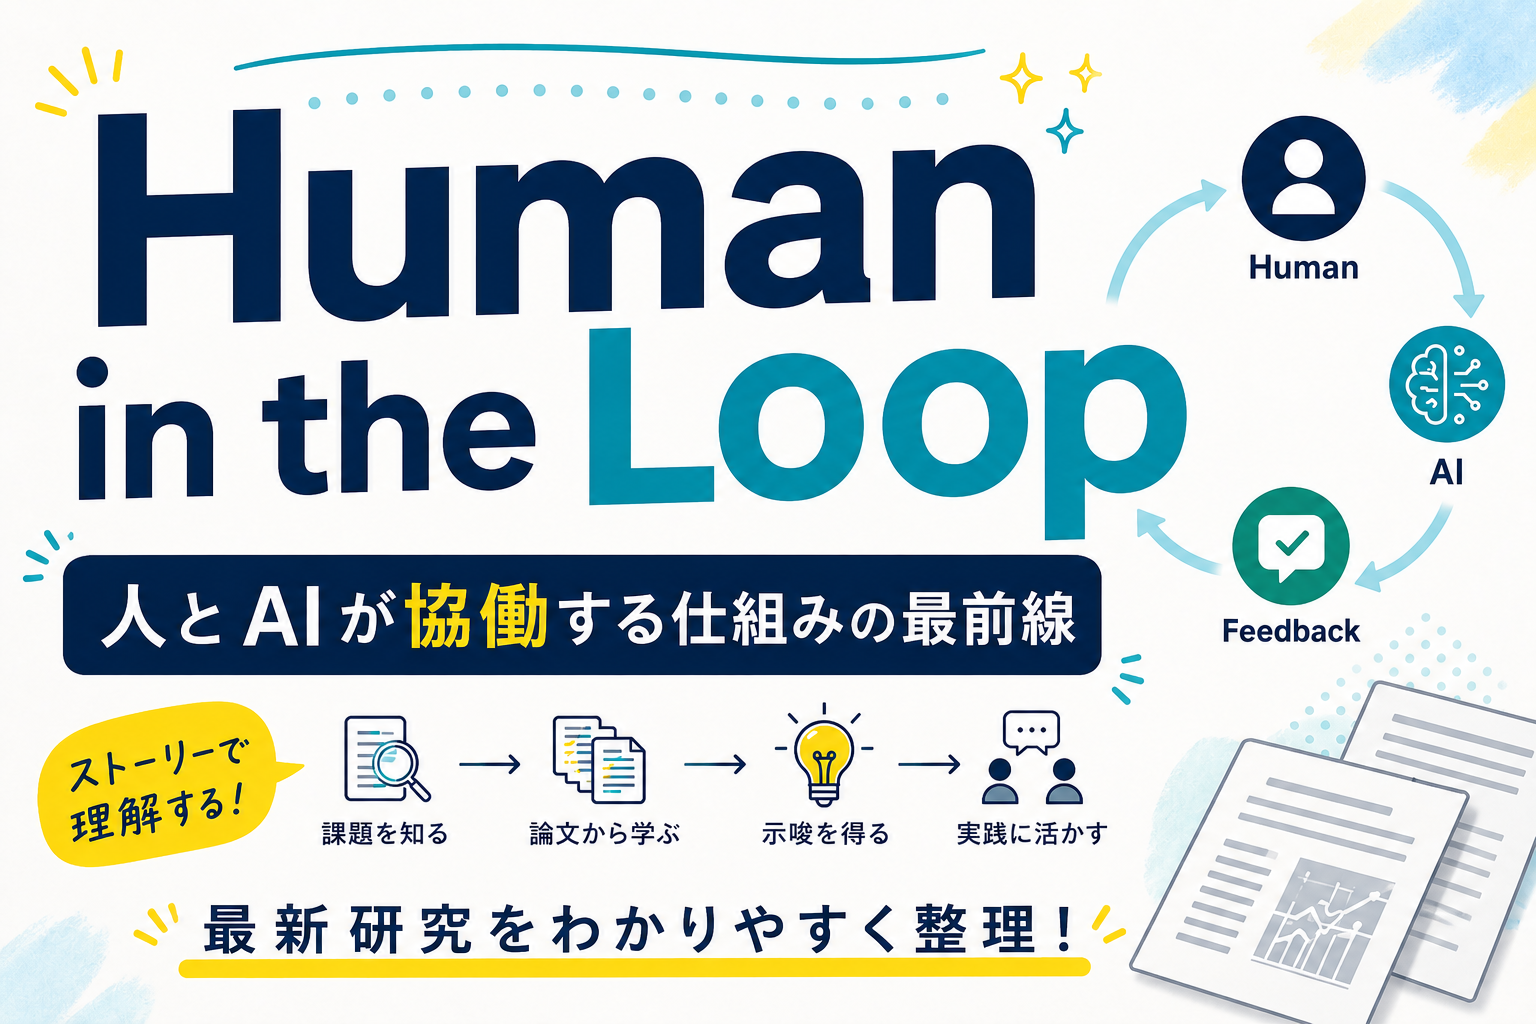
そこで近年登場したのが、Human-in-the-Loop(ヒューマン・イン・ザ・ループ、以下HITL) という言葉です。AIに全部任せるのでも、人間が全部やるのでもなく、要所に人を残してAIと協働させる、という考え方です。
ただ、本当に人を残すと良いのか。残せば安心なのか。残すなら、どこに残すのか。そんな疑問が浮かびます。
この記事では、どちらの立場にも立たず、こうした疑問への答えを論文の中に探していきます。結論をあらかじめ決めず、研究を一つずつたどりながら考えてみたいと思います。
では、いちばん素朴な疑問から始めます。
① そもそも「人を残す」とは、何をすること?
「人を残す」と言っても、具体的には何をどうすることなのでしょうか。
HITLは、単一の手法ではありません。「どこに・どれくらい・いつ」人を挟むかという、幅のある設計の話です(Lazaros ほか, 2026)。整理すると、次の3つの軸で考えられます。
軸 | どういうことか | たとえば |
|---|---|---|
どこに | AIの処理のどの段階に人を置くか | 入力の前/出力の後/重要な判断の手前 |
どれくらい | 人がどの細かさで関わるか | すべてを確認する/例外のときだけ確認する |
いつ | どのタイミングで関わるか | 事前に/リアルタイムで/事後に |
この組み合わせ次第で、HITLにはさまざまな形があります。
文脈の理解や倫理的な判断、説明責任が求められる高リスクな場面ほど、完全な自動化では足りないとされています。とはいえ、人を残せば万事解決というわけでもありません。人手が追いつくか、負担が増えすぎないか、AIの信憑性など、人を残すこと自体にも、こうした課題があると指摘されています。
このような課題を踏まえて、次の疑問が浮かびます。
結局、人を残すと、本当に結果は良くなるのでしょうか?
② 人を残すと、本当に結果は良くなる?
この問いについては、医療分野で「完全自動のAI」「人間(医師)のみ」「両者の協働」を比べた研究があります(Olawade ほか, 2026)。これによると、協働(HITL)のほうが診断精度が高く、医療過誤が減り、患者の安全や臨床家の信頼も高まった、と報告されています。どちらか一方の極端ではなく、人とAIの"協働"がいちばん良いわけです。
しかも、これは特定の用途に限った話ではありません。画像診断、診療の意思決定支援、患者のモニタリング、創薬まで、幅広い場面で同じ傾向が見られたとされています。たとえば画像診断では、AIが読影の時間を縮め、医師の疲労を減らしつつ、最終的な診断は人間が下す。診療判断の支援では、AIが候補やリスクを示し、医師がそれを踏まえて決める。患者のモニタリングでは、AIが異常の兆候を拾い、人が対応を判断する。いずれも「AIが下ごしらえをし、人が最終責任を持つ」という形です。
では、なぜ両端よりも協働が良いのでしょうか。完全自動のAIは速い反面、文脈の理解や倫理的な判断、説明責任の面でどうしても物足りない。一方、人間だけでは、扱える量とスピードに限界がある。両者を組み合わせると、AIの速さと、人間の判断力・責任のとり方が互いを補う。という構図になります。
ただし、この研究はひとつ大事な但し書きを添えています。良い結果が出たのは、人間の専門性が"うまく組み込まれた"ときだ、という点です。ただ人を一人付ければよいのではなく、どこに・どう関与させるかが結果を左右する。この含みは、記事の後半で効いてきます。
「協働が良い」とわかってきました。ただ、AIって結局信用できるのかわからないから人間がやったほうが正確でいいのでは?
良いと言われても、AIが信用できるのか?
③ AIの精度ってどのくらい―「賢く見えるだけ」という引っかかり
実際に生成AIを使った検証もあります(Iyenghar, 2025)。機械の安全性に関するリスク分析に生成AIを使い、専門家がその出力を監視しながら修正を重ねたところ、対象とした4種類の産業設備すべてで、正解とされる分析と完全に一致するまで精度が高まった、と報告されています。しかもAIは、人間が見落としていたケースまで拾い上げることがあったといいます。専門家による評価も、効率・精度・使いやすさのいずれも5段階で4.7〜5.0と高い水準でした。ここでのAIは、人間の専門知識の"置き換え"ではなく、効率を高める"補助"という位置づけです。
ここまでは「やはり協働は効く」という話に見えます。ところが、この研究の題が少し引っかかります。「Clever Hans(賢馬ハンス)」という計算ができるように見えて、実は人間の仕草を読んでいただけの馬の逸話があります。生成AIの出力も、もっともらしく知的に見えて、本当に理解しているとは限らない。だから人間の精査が欠かせない、というわけです。
この「賢く見えるだけかもしれない」という見方は、別の研究とも響き合います。「思考の幻想(The Illusion of Thinking)」(Shojaee ほか, 2025)では、ハノイの塔や川渡りのような、難しさを段階的に上げられるパズルをAIに解かせています。すると、推論を売りにするAIモデルでも、ある複雑さを超えると正解率がほぼ崩れ、しかも本来もっと考える余地があるのに、途中で"考える手を抜く"ような傾向まで見られたといいます。
問題の難しさで分けると、傾向はさらにはっきりします。
問題の難しさ | 何が起きたか |
|---|---|
やさしい | "思考"しない普通のモデルのほうが、むしろ正確 |
中くらい | "思考"する推論モデルが有利 |
難しい | どちらのモデルも崩壊 |
「考えるAIほど強い」とは限らない、というわけです。AIの"思考"は、見かけほど確かなものではないのかもしれません。なお、この結果には実験のやり方をめぐる反論もあり、対象がパズルで実業務とは距離がある点には注意も要ります。
「賢く見えるだけかもしれない」。そう言われると、HITLの大前提が気になってきます。HITLは「人がAIの間違いをチェックする」仕組みのはずです。
そもそも、残した人間は、AIの間違いをちゃんと見抜けているのでしょうか?
④ 残した人間は、AIの間違いを見抜けるのか
これについては、興味深い実験結果があります(Agudo ほか, 2024)。裁判の量刑判断に似た場面で、参加者が複数の被告について判断を下します。そこにAIの助言を自分が判断する前に見せるか、判断したあとに見せるかの順番を変え、しかもその助言がときどき間違っている場合に何が起きるかを調べたものです。
すると、人は誤ったAIの助言を"自分で判断する前"に見ると、判断の精度が下がりました。しかも、あとから考え直しても、最初に見た誤った助言に引きずられたままです。これはいわゆるアンカリングです。逆に、自分で判断してからAIを見たグループは、その影響を受けにくかったです。AIが先か、人が先か、という順番だけで結果が変わったわけです。
一方で、"正しい"AIの助言を見せたときの効果は、思ったほどではありませんでした。条件をより厳しくした実験では、正しい助言による精度の上振れははっきりとは確認されなかったのです。まとめると、正しい支援の恩恵は小さく、誤った支援の害は大きいという非対称です。
ただし、人がAIに何でも盲従したわけではありません。参加者の多くは、AIの助言が手元の証拠と食い違っているときには、その違和感に気づいて流されずに済んでいたようです。裏を返せば、人がAIの誤りに抗えるのは、自分で事実を確かめられるとき。確かめるすべがなければ、引きずられやすくなる、とも読めます。「人を残せば安心」とは言い切れないけれど、「人は必ずAIに流される」わけでもない。ただ条件しだい、という冷静な結果です。
残した人間も、置き方を間違えれば、かえってAIの誤りに引きずられる。だとすると
どう残せば、その落とし穴を避けられるのでしょうか?
⑤ では、どう残せばいいのか
ここまでたどってきた研究が、そのまま設計のヒントになります。
設計のコツ | 具体的にどうする | 根拠 |
|---|---|---|
順序を工夫する | 人がまず判断し、あとでAIの出力を見せる | Agudo ほか, 2024 |
リスクで濃淡をつける | 誤りの影響が大きい業務ほど、人を厚く関与させる | Olawade ほか, 2026 |
設計として捉える | 「どこに・どれくらい・いつ」人を挟むかを決める | Lazaros ほか, 2026 |
いずれも、ばらばらの工夫というより、一つの考え方につながります。HITLは「とりあえず人を付ける」ことではなく、設計の問題なのです。
おわりに ― 経営にとっての問い
論文を順にたどってみると、扱う領域は医療・機械安全・司法とさまざまでも、向いている方向は近いように読めます。ここまでの研究を一枚にまとめると、こうなります。
問い | 研究からわかったこと | 出典 |
|---|---|---|
人を残すとは? | 単一の手法ではなく「どこに・どれくらい・いつ」の設計 | Lazaros ほか, 2026 |
結果は良くなる? | 完全自動とも人間のみとも比べ、協働が最も良い | Olawade ほか, 2026 |
現場でも効く? | 効く。ただしAIは「賢く見えるだけ」の面もある | Iyenghar 2025/Shojaee ほか 2025 |
人は誤りを見抜ける? | 誤ったAIに引きずられ、恩恵は非対称。ただし常にではない | Agudo ほか, 2024 |
どう残す? | 順序・リスクの濃淡・設計として捉える | 上記より |
つまり、「AIだけ」でも「人だけ」でもなく協働が効く。ただし人を残すこと自体に落とし穴があり、どこに・どう残すかの設計が結果を左右する、という具合です。
だとすれば、経営として考えるべきは「人を残すか否か」ではなく、むしろ次のような問いなのかもしれません。
- リスクの高い業務ほど、人の関与を厚くしているか
- 人がAIに引きずられない順序になっているか(人に先に判断させているか)
- 現場がAIを盲信していないか。逆に、有用なのに使われていないか
- AIの出力が「正しく見えるだけ」かもしれない、という前提で点検できているか
「人を残せば安心」でも「AIに任せれば効率的」でもなく、その中間をどう設計するか。少なくとも今回たどった論文からは、そこが問いどころのように見えてきます。
では、その設計をどう進めるか ― Askhubが一緒に考えます
とはいえ、「どこに・どれくらい・いつ人を残すか」を自社の業務に合わせて設計するのは、そう簡単ではありません。今回の論文が示していたとおり、効果が出るのは人をただ付けたときではなく、その関与がうまく組み込まれたとき。どの業務のどこに人を残すべきかは、扱うリスクや業務の流れによって変わり、正解は会社ごとに違います。
インターセクトが提供する「Askhub」は、まさにこの「どこに・どれくらい・いつ人を残すか」までを含めて、業務に合わせたAIエージェントを設計します。「この業務をAIに任せたい」「でも、ここは人の判断を残したい」といったご要望に対して、設計から導入・運用まで一貫してご支援します。
「人を残したほうがいいのはわかったけれど、自社でどう設計すればいいかは悩ましい」そんな方こそ、まずはお気軽にAskHubへご相談ください。
参照論文
- Lazaros, K., Vrahatis, A. G., & Kotsiantis, S. (2026). Human-in-the-loop artificial intelligence: A systematic review of concepts, methods, and applications. Entropy, 28(4), 377.
- Olawade, D. B., Plabon, S. B., Ojo, A., Ogunbona, M. A., Makanjuola, B. D., & Olasilola, R. (2026). Human in the loop artificial intelligence in healthcare: applications, outcomes, and implementation challenges. International Journal of Medical Informatics, 106362.
- Iyenghar, P. (2025). Clever Hans in the loop? A critical examination of ChatGPT in a human-in-the-loop framework for machinery functional safety risk analysis. Eng, 6(2), 31.
- Agudo, U., Liberal, K. G., Arrese, M., & Matute, H. (2024). The impact of AI errors in a human-in-the-loop process. Cognitive Research: Principles and Implications, 9(1), 1.
- Shojaee, P., Mirzadeh, I., Horton, M., Bengio, S., & Farajtabar, M. (2026). The illusion of thinking: Understanding the strengths and limitations of reasoning models via the lens of problem complexity. Advances in Neural Information Processing Systems, 38, 108018-108059.